Исследование надежности опросниковой диагностики соционических величин
Исследование надежности опросниковой диагностики соционических величин
В.Л.Таланов
С-Петербург, июнь 2017
Оглавление
Третий фактор - Диффузия ошибок со стороны частых типов к редким.
Интеркорреляции внутритестовых показателей, связанных с надежностью теста
Проверка ретестовой надежности анкет серии MOLTI по анкетам одной и той же формы.
Статья содержит 10 рисунков, 22 таблицы.
Статья дает подробный ответ на все вопросы, которые возникали либо могли возникнуть в связи с надежностью методов соционической диагностики с использованием опросников. Всем, в ком еще «не остыли» эти вопросы, как и тем, кто занимается опросниковой диагностикой профессионально, рекомендуется в этой статье максимально подробно разобраться. В ней местами много математики – но это неизбежно.
В статье подробно и детально проанализированы различные вопросы надежности при измерении соционических величин социодиагностическими опросниками. В качестве материала для анализа использованы социодиагностические опросники В.Л.Таланова, но выводы, формулы и табличные данные по итогам этого рассмотрения в своем большинстве будут полезными не только для узкого круга профессиональных социоников, но и для гораздо более широкого круга специалистов, которые занимаются разработкой любых психодиагностических опросников (не обязательно соционических) либо интерпретацией их результатов.
В статье показано, как применять метод Кронбаха для оценки надежности опросниковых шкал, основанных на измерении корреляцмй или ковариаций ответов респондентов с диагностическими векторами. Разработаны специальные параметры f и Z для прогноза сходимости двух независимых дискретных диагнозов на выборке респондентов, которые в реальности распределены континуально между реперными точками диагнозов. С использованием параметра f (раздел 8 статьи) показано, что психологическое пространство между дискретными психотипами действительно является континуально заполненным респондентами выборки. Показано, что одновременная близость респондента к двум, а то и к трем типам является нередким случаем и является причиной обязательного и рассчитываемого снижения сходимости независимых диагнозов даже при условии высокой надежности типного профиля респондентов и значительной высоты этого профиля. Конкретно в отношении социодиагностических опросников Таланова (в том числе опросников серии MOLTI) показано, что измеряемые ими соционические показатели удовлетворяют всем требованиям критериев надежности (альфы Кронбаха, корреляций тождественных частей и ретестовых корреляций), которые предъявляются к профессиональным психодиагностическим опросникам. С точки зрения требований к надежности тестирования разработаны количественные критерии для анкетных вопросов, позволяющие производить математически осмысленный отбор вопросов в диагностические шкалы любых психологических опросников. Для случая диагностики соционических типов подробно проанализированы все факторы, приводящие к неодинаковому уровню накопления ошибок (а в итоге – и к разной сходимости) в различных типных группах испытуемых. При этом отдельно рассмотрены случаи формирования этих типных групп как по результатам самотипирования, так и по результатам анкетного типирования. Показан способ раздельного расчета вероятностей правильного определения истинного типа при самотипировании и при анкетной диагностике, исходя из сходимости соответствующих диагнозов и из дисперсии средних сходимостей в 16-ти группах психотипов (рассчитанной отдельно для типных групп по самотипированию и по анкетной диагностике). Для самотипирования расчет показывает средневыборочнвую вероятность правильного определения истинного типа около 63%, а для диагностики по анкетам MOLTI c 220 диагностическими вопросами – в среднем по выборке около 83%.
Социодиагностические опросники В.Л.Таланова (надежность которых в настоящей статье анализируется) являются самообучающимися с реккурентной процедурой обучения и с первоначальной опорой на самотипирование испытуемых (на их психотипы, заявляемые респондентами по их самооценке параллельно с опросниковым типированием).
Первый этап обучения опросников. Предположим, что у нас имеются ответы достаточно большого количества испытуемых, заявивших свой психотип по самооценке, на некий анкетный вопрос. В группе каждого из заявленных психотипов мы можем подсчитать средний балл ответа на этот вопрос. Обычно эта процедура проводится с ответами испытуемых, предварительно очищенными от влияния социальной диссимуляции и индивидуальных особенностей заполнения (вроде предпочтений высоких либо низких оценок) и окончательно нормированными (при нормировке сырые баллы ответов - от 1 до 5 – пересчитываются в нормированные оценки анкетных пунктов с нулевым выборочным средним и единичным выборочным стандартным отклонением). Ответы разных испытуемых, заявивших один и тот же тип, учитываются при подсчете среднетипных баллов с разным весом. Весовая функция при этом оптимальна (рассчитана по итогам математических экспериментов) и отражает как уверенность испытуемого в своем заявляемом типе, так и его соционическую компетентность, зависящую от его стажа знакомства с соционикой.
С учетом того, что, как показывают расчеты, средняя достоверность самотипирования у респондентов, заявивших свой тип, составляет около 62%-66%, то этой добротности формирования обучающих типных выборок оказывается вполне достаточно для получения вполне надежных типных профилей для каждого обследованного анкетного пункта. Правда, в этой процедуре есть определенные «подводные камни» - например, во-первых, редкие в выборке психотипы загрязняются ошибками (ложными тревогами) со стороны более частых в выборке психотипов (происходит так называемая диффузия ошибок со стороны более частых типов в сторону более редких). Во-вторых, ввиду непрерывного распределения людей в психологическом пространстве между психотипами средние значения координат редких в выборке психотипов также оказываются смещенными в сторону более частых близких по свойствам психотипов (эффект «статистического склона»). В-третьих, есть еще и эффект «социальной модности», то есть большей или меньшей социальной популярности выбора каждого из психотипов при самотипировании. Все эти систематические погрешности для повышения точности и адекватности диагностики надо учитывать и корректировать. Благо, на самом деле все эти нежелательные эффекты довольно легко (во всяком случае – надежно) математически моделируются и потому на основе полученных математических моделей полностью расчетным образом компенсируются (механизмам их корректировки, в частности, посвящена настоящая статья). В результате, в окончательном итоге, мы на основе обучающей выборки получаем объективную и практически не смещенную картину усредненных по каждой обучающей типной группе нормированных ответов на каждый интересующий нас анкетный вопрос, то есть для каждого анкетного пункта получаем набор из 16-ти алгебраических чисел – типный профиль этого анкетного пункта.
Второй этап обучения опросников. Имея опросник, составленный из, допустим, 300 анкетных пунктов, для каждого из которых на обучающей выборке рассчитан типный профиль, мы фактически имеем 16 диагностических векторов (по вектору для каждого ТИМа), каждый из которых состоит из 300 алгебраических чисел, «эталонных ответов» – усредненных по типной группе нормированных ответов респондентов обучающей выборки. Сравнивая вектор нормированных ответов нового испытуемого на эти же 300 вопросов с 16-ю векторами эталонных ответов (а именно, измеряя линейную корреляцию между ответами испытуемого и каждым из 16-ти диагностических векторов), мы получаем для каждого из испытуемых набор из 16 чисел, характеризующих близость ответов испытуемого к каждому из 16-ти «стандартных» психотипов. Тот психотип, для которого получается наивысший коэффициент корреляции с ответами испытуемого, принимается за подлинный психотип испытуемого. На новых выборках (ранее не участвовавших в процедуре обучения с получением первичных диагностических коэффициентов) совпадение этих новых вновь диагностированных психотипов с заявляемыми самими испытуемыми (то есть с психотипами самотипирования) составляет в среднем, на разных опросниках, от 55 до 61%. Детальный математический расчет показывает, что достоверность вновь диагностированных психотипов существенно выше, чем заявляемых по самотипированию (этот вопрос также рассматривается в настоящей статье). Если первая, как выше указывалось, составляет около 62-66%, то вторая дает достоверность отнесения к подлинному (то есть объективно наиболее близкому стандартному психотипу) уже от 80% до 95% (опять же, по-разному для разных опросников, в зависимости от их длины и подбора вопросов). Вновь полученные типные диагнозы (более точные и, кроме того, имеющиеся уже для всех испытуемых, а не только для их части, заявившей свой тип) формируют обучающую выборку следующего, второго уровня, на которой опять же рассчитываются средние по психотипам ответы испытуемых на каждый анкетный вопрос, то есть формируются новые, уточненные и более контрастные (менее зашумленные) вектора эталонных ответов для каждого психотипа. Ответы разных испытуемых, даже принадлежащих к одному типу, при этом внутритипном усреднении учитываются также с разным весом – но на этот раз пропорционально функции фишера от линейного коэффициента корреляции между эталонными ответами соответствующего стандартного психотипа, к которому наиболее близок испытуемый, и вектором нормированных ответов испытуемого. Полученные в итоге диагностические коэффициенты анкетных вопросов (то есть их числовые типные профили) можно уже использовать в качестве окончательных.
Табл.1. Перевод типных профилей в признаковые (для любого типного профиля соответствующий ему показатель любой признаковой нагрузки получается скалярным умножением строки 16-ти чисел-нагрузок соответствующего типного профиля на строку алгебраических коэффициентов для интересующего нас признака в настоящей таблице). Все числа в таблице по модулю равны 1/16.
| ИЛЭ | ЛИИ | СЭИ | ЭСЭ | СЛЭ | ЛСИ | ИЭИ | ЭИЭ | СЭЭ | ЭСИ | ИЛИ | ЛИЭ | ИЭЭ | ЭИИ | СЛИ | ЛСЭ | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| экстрав. | 0,0625 | -0,0625 | -0,0625 | 0,0625 | 0,0625 | -0,0625 | -0,0625 | 0,0625 | 0,0625 | -0,0625 | -0,0625 | 0,0625 | 0,0625 | -0,0625 | -0,0625 | 0,0625 |
| иррац. | 0,0625 | -0,0625 | 0,0625 | -0,0625 | 0,0625 | -0,0625 | 0,0625 | -0,0625 | 0,0625 | -0,0625 | 0,0625 | -0,0625 | 0,0625 | -0,0625 | 0,0625 | -0,0625 |
| статика | 0,0625 | 0,0625 | -0,0625 | -0,0625 | 0,0625 | 0,0625 | -0,0625 | -0,0625 | 0,0625 | 0,0625 | -0,0625 | -0,0625 | 0,0625 | 0,0625 | -0,0625 | -0,0625 |
| интуиц. | 0,0625 | 0,0625 | -0,0625 | -0,0625 | -0,0625 | -0,0625 | 0,0625 | 0,0625 | -0,0625 | -0,0625 | 0,0625 | 0,0625 | 0,0625 | 0,0625 | -0,0625 | -0,0625 |
| рассуд. (перифер.) | 0,0625 | 0,0625 | 0,0625 | 0,0625 | -0,0625 | -0,0625 | -0,0625 | -0,0625 | -0,0625 | -0,0625 | -0,0625 | -0,0625 | 0,0625 | 0,0625 | 0,0625 | 0,0625 |
| тактика | 0,0625 | -0,0625 | -0,0625 | 0,0625 | -0,0625 | 0,0625 | 0,0625 | -0,0625 | -0,0625 | 0,0625 | 0,0625 | -0,0625 | 0,0625 | -0,0625 | -0,0625 | 0,0625 |
| беспечн. | 0,0625 | -0,0625 | 0,0625 | -0,0625 | -0,0625 | 0,0625 | -0,0625 | 0,0625 | -0,0625 | 0,0625 | -0,0625 | 0,0625 | 0,0625 | -0,0625 | 0,0625 | -0,0625 |
| логика | 0,0625 | 0,0625 | -0,0625 | -0,0625 | 0,0625 | 0,0625 | -0,0625 | -0,0625 | -0,0625 | -0,0625 | 0,0625 | 0,0625 | -0,0625 | -0,0625 | 0,0625 | 0,0625 |
| весел. (восходящ) | 0,0625 | 0,0625 | 0,0625 | 0,0625 | 0,0625 | 0,0625 | 0,0625 | 0,0625 | -0,0625 | -0,0625 | -0,0625 | -0,0625 | -0,0625 | -0,0625 | -0,0625 | -0,0625 |
| конструкт. | 0,0625 | -0,0625 | -0,0625 | 0,0625 | 0,0625 | -0,0625 | -0,0625 | 0,0625 | -0,0625 | 0,0625 | 0,0625 | -0,0625 | -0,0625 | 0,0625 | 0,0625 | -0,0625 |
| уступч. | 0,0625 | -0,0625 | 0,0625 | -0,0625 | 0,0625 | -0,0625 | 0,0625 | -0,0625 | -0,0625 | 0,0625 | -0,0625 | 0,0625 | -0,0625 | 0,0625 | -0,0625 | 0,0625 |
| квестим | 0,0625 | 0,0625 | -0,0625 | -0,0625 | -0,0625 | -0,0625 | 0,0625 | 0,0625 | 0,0625 | 0,0625 | -0,0625 | -0,0625 | -0,0625 | -0,0625 | 0,0625 | 0,0625 |
| демократ (индивид.) | 0,0625 | 0,0625 | 0,0625 | 0,0625 | -0,0625 | -0,0625 | -0,0625 | -0,0625 | 0,0625 | 0,0625 | 0,0625 | 0,0625 | -0,0625 | -0,0625 | -0,0625 | -0,0625 |
| позитив. | 0,0625 | -0,0625 | -0,0625 | 0,0625 | -0,0625 | 0,0625 | 0,0625 | -0,0625 | 0,0625 | -0,0625 | -0,0625 | 0,0625 | -0,0625 | 0,0625 | 0,0625 | -0,0625 |
| процесс (правость) | 0,0625 | -0,0625 | 0,0625 | -0,0625 | -0,0625 | 0,0625 | -0,0625 | 0,0625 | 0,0625 | -0,0625 | 0,0625 | -0,0625 | -0,0625 | 0,0625 | -0,0625 | 0,0625 |
Табл.2. Перевод признаковых профилей в функциональные (величина каждой функции получается скалярным умножением строки 15-ти признаковых нагрузок на строку коэффициентов из этой таблицы для интересующей нас функции)
| экстрав. | иррац. | статика | интуиц. | рассуд. (перифер.) | тактика | беспечн. | логика | весел. (восходящ) | конструкт. | уступч. | квестим | демократ (индивид.) | позитив. | процесс (правость) | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| БИ | -1 | 1,5 | -1 | 3 | -3 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| ЧИ | 1 | 1,5 | 1 | 3 | 3 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| БС | -1 | 1,5 | -1 | -3 | 3 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| ЧС | 1 | 1,5 | 1 | -3 | -3 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| БЛ | -1 | -0,75 | 1 | 0 | 0 | 0 | 0 | 3 | 3 | 0 | 0 | 0 | 0 | 0 | 0 |
| ЧЛ | 1 | -0,75 | -1 | 0 | 0 | 0 | 0 | 3 | -3 | 0 | 0 | 0 | 0 | 0 | 0 |
| БЭ | -1 | -0,75 | 1 | 0 | 0 | 0 | 0 | -3 | -3 | 0 | 0 | 0 | 0 | 0 | 0 |
| ЧЭ | 1 | -0,75 | -1 | 0 | 0 | 0 | 0 | -3 | 3 | 0 | 0 | 0 | 0 | 0 | 0 |
| БК | -1 | -0,75 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 3 | 3 | 0 | 0 |
| ЧК | 1 | -0,75 | -1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 3 | -3 | 0 | 0 |
| БД | -1 | -0,75 | 1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | -3 | -3 | 0 | 0 |
| ЧД | 1 | -0,75 | -1 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | -3 | 3 | 0 | 0 |
Табл.3. Обратный перевод признаковых профилей в типные (нагрузка каждого ТИМа в типном профиле получается скалярным умножением строки 15-ти признаковых нагрузок на строку коэффициентов в таблице, соответствующую интересующему нас ТИМу)
| экстрав. | иррац. | статика | интуиц. | рассуд. (перифер.) | тактика | беспечн. | логика | весел. (восходящ) | конструкт. | уступч. | квестим | демократ (индивид.) | позитив. | процесс (правость) | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| ИЛЭ | 1 | 1 | 1 | 1 | 1 | 1 | 1 | 1 | 1 | 1 | 1 | 1 | 1 | 1 | 1 |
| ЛИИ | -1 | -1 | 1 | 1 | 1 | -1 | -1 | 1 | 1 | -1 | -1 | 1 | 1 | -1 | -1 |
| СЭИ | -1 | 1 | -1 | -1 | 1 | -1 | 1 | -1 | 1 | -1 | 1 | -1 | 1 | -1 | 1 |
| ЭСЭ | 1 | -1 | -1 | -1 | 1 | 1 | -1 | -1 | 1 | 1 | -1 | -1 | 1 | 1 | -1 |
| СЛЭ | 1 | 1 | 1 | -1 | -1 | -1 | -1 | 1 | 1 | 1 | 1 | -1 | -1 | -1 | -1 |
| ЛСИ | -1 | -1 | 1 | -1 | -1 | 1 | 1 | 1 | 1 | -1 | -1 | -1 | -1 | 1 | 1 |
| ИЭИ | -1 | 1 | -1 | 1 | -1 | 1 | -1 | -1 | 1 | -1 | 1 | 1 | -1 | 1 | -1 |
| ЭИЭ | 1 | -1 | -1 | 1 | -1 | -1 | 1 | -1 | 1 | 1 | -1 | 1 | -1 | -1 | 1 |
| СЭЭ | 1 | 1 | 1 | -1 | -1 | -1 | -1 | -1 | -1 | -1 | -1 | 1 | 1 | 1 | 1 |
| ЭСИ | -1 | -1 | 1 | -1 | -1 | 1 | 1 | -1 | -1 | 1 | 1 | 1 | 1 | -1 | -1 |
| ИЛИ | -1 | 1 | -1 | 1 | -1 | 1 | -1 | 1 | -1 | 1 | -1 | -1 | 1 | -1 | 1 |
| ЛИЭ | 1 | -1 | -1 | 1 | -1 | -1 | 1 | 1 | -1 | -1 | 1 | -1 | 1 | 1 | -1 |
| ИЭЭ | 1 | 1 | 1 | 1 | 1 | 1 | 1 | -1 | -1 | -1 | -1 | -1 | -1 | -1 | -1 |
| ЭИИ | -1 | -1 | 1 | 1 | 1 | -1 | -1 | -1 | -1 | 1 | 1 | -1 | -1 | 1 | 1 |
| СЛИ | -1 | 1 | -1 | -1 | 1 | -1 | 1 | 1 | -1 | 1 | -1 | 1 | -1 | 1 | -1 |
| ЛСЭ | 1 | -1 | -1 | -1 | 1 | 1 | -1 | 1 | -1 | -1 | 1 | 1 | -1 | -1 | 1 |
- Метод Кронбаха для расчета надежности (расчет коэффициента «альфа» Кронбаха для используемых опросниками соционических шкал). Альфа Кронбаха – теоретическая часть
В опросниках Таланова в качестве диагностической процедуры для расчета любых соционических шкал используется вычисление коэффициентов линейной корреляции между векторами диагностических коэффициентов с одной стороны, и вектором ответов респондента на соответствующие диагностические вопросы анкеты – с другой стороны (причем перед взятием корреляций ответы всех испытуемых выборки на каждый вопрос анкеты предварительно корректируются на социальную диссимуляцию и индивидуальные стилевые особенности заполнения каждого респондента, после чего в конце этой предварительной процедуры они нормируются по всей выборке респондентов до достижения у ответов на каждый анкетный пункт нулевого выборочного среднего и единичного выборочного стандартного отклонения).
Рассчитываемый в качестве показателя каждой соционической шкалы коэффициент линейной корреляции пропорционален, согласно его математическому определению, скалярному произведению двух векторов: вектора нормированных ответов респондента (ответов, очищенных от части несоционических артефактов) на вектор соответствующих этим же вопросам заранее известных диагностических коэффициентов. Иначе говоря, рассчитываемый для респондента итоговый показатель каждой соционической шкалы пропорционален алгебраической сумме всех ответов респондента на диагностические анкетные вопросы, причем при суммировании эти нормированные баллы ответов почленно домножаются на соответствующие диагностические коэффициенты. Эта пропорциональность корреляций взвешенным суммам открывает возможность для точной количественной оценки надежности каждой рассчитанной таким способом шкалы по методу Кронбаха, специально разработанному Ли Кронбахом для подобных случаев.
Пусть N – число диагностических вопросов анкеты; M – число обследованных респондентов (объем выборки);
{b_(i)} – вектор ответов каждого респондента на N диагностических вопросов (ответов, для каждого отдельного вопроса нормированных по выборке всех M респондентов);
{c_(i)} – вектор диагностических коэффициентов для последовательности N диагностических вопросов;
{b_(i)*c_(i)} – для каждого респондента вектор его ответов на все N вопросов, где ответы домножены на соответствующие диагностические коэффициенты.
F = ∑1N(bi × ci) – расчетная величина соционической шкалы, равная взвешенной сумме произведений (ответов - на диагностические коэффициенты), то есть алгебраической сумме всех N элементов вектора {b_(i)*c_(i)}. В случае расчета соционических шкал по корреляциям, величина F еще и должна в конце домножаться на некую константу, но при оценке надежности измерений мы это домножение будем игнорировать, поскольку домножение на константу не влияет на расчетную статистическую надежность измеряемой величины. Таким образом, расчет надежности линейных корреляций мы можем абсолютно эквивалентно заменить на более понятный и простой расчет надежности взвешенных сумм F, что мы и будем всюду в этом разделе далее до самого конца делать.
S_(i) – стандартное отклонение величины b_(i)*c_(i) в выборке М испытуемых (где b_(i)*c_(i) - ответы респондентов на i-й вопрос анкеты, домноженные на соответствующий диагностический коэффициент);
D_(i)=S_(i)^2 – дисперсия величины b_(i)*c_(i) в выборке М испытуемых;
S_(F) – стандартное отклонение выше определенной шкальной величины F в выборке М испытуемых;
D_(F)=S_(F)^2 – дисперсия шкальной величины F в выборке М испытуемых.
D_(N)=∑1NDi – сумма выборочных дисперсий D_(i) по всем N диагностическим вопросам анкеты.
Согласно классической теории теста, достоверность результатов тестирования (она же – надежность) может быть выражена как отношение дисперсий истинной и общей оценок. Дисперсия общей оценки в свою очередь равна сумме дисперсии ошибки и дисперсии истинной оценки. Когда в общем полученном результате дисперсия ошибки равна нулю, это отношение равно 1. Когда же в общем полученном результате нулю равняется дисперсия истинной оценки, тогда это отношение, выражающее надежность, обращается в ноль.
D_(F(вопросная шкала из N вопросов)) = D_(истина) + D_(случайный шум)
А (достоверность) = D_(истина)/(D_(истина) + D_(случайный шум)) = (D_(F) - D_(случайный шум))/D_(F)
Можно показать, что искомое отношение в самом общем случае равно:
A= N/(N-1)*(D_(F)-D_(N))/D_(F)
Эта выведенная Ли Кронбахом формула, характеризующая надежность любой шкалы опросникового теста, состоящей из N вопросов, называется коэффициентом «Альфа» Кронбаха, или коротко - «альфой Кронбаха», или просто «коэффициентом надежности теста». Коэффициент А принимает значения от 0 (минимальное) до 1 (максимальное). Чем А выше, тем выше измерительная надежность шкалы. В психологии принято считать, что для профессиональных диагностических опросниковых шкал А должно быть в районе 0,9 либо выше.
Если R – линейная корреляция между откуда-то известными ИСТИННЫМИ ЗНАЧЕНИЯМИ ПРИЗНАКА и моделирующими его значениями шкалы F (составленной из суммы вопросов), то R*R=R^2=A (это общеизвестный вывод, доказываемый в матстатистике).
Чтобы составленная из N анкетных вопросов шкала имела A=0 (случай полной ненадежности, за шкалой ничего не стоит, она никакой сущности не измеряет), достаточно, чтобы все элементы шкалы b_(i)*c_(i) либо имели нулевые взаимные корреляции (то есть были строго независимыми друг от друга переменными), либо чтобы их взаимная скоррелированность была строго «шумовой», то есть чтобы в их интеркорреляционной матрице половина корреляций получалась со знаком плюс, а другая половина – со знаком минус, причем в сумме они давали бы ноль.
Чтобы составленная из N анкетных вопросов шкала имела A=1 (случай полной, стопроцентной надежности, когда все вопросы шкалы строго нацелены на измерение одной и той же сущности, причем все вопросы делают это без случайной ошибки), необходимо, чтобы все взаимные корреляции в интеркорреляционной матрице переменных b_(i)*c_(i) строго равнялись единице. Однако оказывается, что даже если все корреляции в этой интеркорреляционной матрице пусть и положительные, но весьма умеренные по своей абсолютной величине (то есть отнюдь по величине не единица, а, например, все равны 0,2), то за счет простого увеличения числа вопросов в шкале коэффициент надежности Кронбаха тоже можно сколько угодно близко приближать к желанной единице.
Чтобы было понятнее, почему это получается, и вообще как работает формула Кронбаха, рассмотрим простейший случай, когда для всех N вопросов все S_(i) одинаковые, равны друг другу (такое возможно, если всем вопросам соответствуют одинаковые по абсолютной величине диагностические коэффициенты), и тогда соответственно D_(N)=N*D_(i)= N*S_(i)*S_(i) .
Если все вопросы шкалы имеют друг с дружкой нулевую корреляцию (абсолютно независимые переменные, из чего для шкалы должна получиться нулевая надежность), тогда при переходе от отдельных вопросов к построенной на них шкале оказывается, что складываются дисперсии ответов на эти вопросы: D_(F)=N*D_(i)= D_(N)=N^0*D_(N)
Тогда A = N/(N-1)*(D_(F)-D_(N))/D_(F) = N/(N-1)*( N*D_(i) - N*D_(i))/ N*D_(i) = 0
Если все вопросы шкалы имеют друг с дружкой единичную корреляцию (тождественные переменные, из чего для шкалы в конце концов должна получиться единичная надежность), тогда при переходе от отдельных вопросов к построенной на них шкале оказывается, что складываются не дисперсии, а стандартные отлонения ответов на эти вопросы: S_(F)=N*S_(i) Что же до дисперсии величины F, то D_(F)= S_(F)*S_(F) = (N*S_(i))*(N*S_(i)) =N^2* S_(i)^2= N*(N* S_(i)^2)= N*D_(N)=N^1*D_(N)
Тогда A = N/(N-1)*(D_(F)-D_(N))/D_(F) = N/(N-1)*( N*D_(N) - D_(N))/ N*D_(N) = N/(N-1)*( N*D_(N) - D_(N))/ N*D_(N)= N/(N-1)*(N-1)/N =1
В промежуточном случае, когда вопросы шкалы скоррелированы между собою с коэффициентом линейной корреляции, который больше нуля, но меньше единицы, мы получаем:
D_(F) = N^(a) *D_(N) = N^a*D_(N) (где 0<а<1);
A = N/(N-1)*(D_(F)-D_(N))/D_(F) = N/(N-1)*( N^a*D_(N) - D_(N))/ N^a*D_(N) = N/(N-1)*(1-1/N^a)
При любом ненулевом, но меньшем единицы положительном значении корреляции между вопросами шкалы и соответствующем значении положительного параметра «а» (тоже лежащем в диапазоне от 0 до 1) с увеличением N будет расти, стремясь к 1, и значение показателя А, выраженного последней формулой.
Для профессиональных психологических тестов принято считать, что показатель надежности А для их шкал должен быть на уровне примерно 0,9 (не ниже), то есть дисперсия эмпирически измеренной по опроснику шкалы должна включать в себя не менее 90% дисперсии истинной величины, на измерение которой шкала, собственно, и нацелена.
Не трудно для разных значений параметра «а» рассчитать потребное для этого количество вопросов, из которых должна состоять шкала.
N/(N-1)*(1-1/N^a)=0,9
Решения этого уравнения (относительно нахождения числа требуемых вопросов N, где N>1, для достижения надежности А=0,9) при различных значениях параметра а (0<a<1) приведены в таблице 4:
Табл.4
| a | N | А Кронбаха |
|---|---|---|
| 0,05 | 1E+20 | 0,90000 |
| 0,10 | 1E+10 | 0,90000 |
| 0,15 | 4641712 | 0,90000 |
| 0,20 | 99956 | 0,90000 |
| 0,25 | 9964 | 0,90000 |
| 0,30 | 2124 | 0,90000 |
| 0,35 | 694 | 0,90002 |
| 0,40 | 294 | 0,90010 |
| 0,45 | 147 | 0,90027 |
| 0,50 | 81 | 0,90000 |
| 0,55 | 49 | 0,90079 |
| 0,60 | 30 | 0,90007 |
| 0,65 | 20 | 0,90245 |
| 0,70 | 13 | 0,90345 |
| 0,75 | 8 | 0,90260 |
| 0,80 | 5 | 0,90507 |
| 0,85 | 3 | 0,91043 |
| 0,90 | 2 | 0,92823 |
| 0,95 | 2 | 0,96474 |
Из приведенной таблицы видно, что потребное для обеспечения 90% надежности количество вопросов анкетной шкалы очень быстро растет с уменьшением параметра а, и вопросы, которые обеспечивают шкале ее параметр а меньший чем 0,40, в диагностические опросниковые шкалы включать абсолютно нецелесообразно.
Чтобы прояснить для читателя практический смысл параметра а и связать его с более наглядными и понятными характеристками анкетных вопросов (с их попарной скоррелированностью, а также их скоррелированностью с истинным значением измеряемой величины, а также из процентным дисперсионным составом – то есть какая в каждом вопросе доля дисперсии истинной измеряемой величины, помимо статистического шума), мы методом математического моделирования получили и приводим еще одну иллюстрирующую таблицу 5:
Табл.5
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 |
| P1 -коэффициент вклада распределенной по Гауссу стандартно нормированной ИСТИНЫ в каждый анкетный пункт, сложенный из независимых ИСТИНЫ и ШУМА | P2 - коэффициент вклада распределенного по Гауссу и стандартно нормированного ШУМА в каждый анкетный пункт, сложенный из независимых ИСТИНЫ и ШУМА P2=1-P1 | доля дисперсии ИСТИНЫ в каждом анкетном пункте шкалы =P1^2/(P1^2+P2^2) | Соответствующая доля в анкетном пункте дисперсии статистического ШУМА либо прочих факторов, не имеющих отношения к измеряемой ИСТИНЕ =P2^2/(P1^2+P2^2) | средн коррел анкетных пунктов между собой (на очень большой выборке, около 10000 человек). Равна доле дисперсии общей ИСТИНЫ в каждом пункте шкалы (см. столбик 3) | средн коррел каждого анкетного пункта с независимо от любых испытаний известной ИСТИНОЙ | КВАДРАТ предыдущей корреляции (столбик 6 таблицы). Этот показатель оказывается равен корреляции анкетных пунктов между собой (см. столбик 5) и также равен доле дисперсии ИСТИНЫ в каждом анкетном пункте (см. столбик 3) | средн коррел каждого анкетного пункта с их суммой F (шкала F составлена в данном случае из трех анкетных пунктов) | Коррел между F (шкалой, составленной из суммы трех анкетных пунктов) и независимо известной ИСТИНОЙ | Квадрат предыдущей корреляции (столбик 9 таблицы). Эта величина оказывается равной надежности А для шкалы F (см. столбик 12). | а -параметр, в степень которого надо возвести число анкетных вопросов N в формуле: DF= Na*DN, где DF –полная дисперсия шкалы F, составленной из N анкетных пунктов, DN– приблизительная дисперсия шума в составе F, равная простой сумме дисперсий всех N анкетных пунктов, взятых по отдельности. | A- альфа Кронбаха, надежность шкалы F, составленной из суммы трех анкетных пунктов (альфа Кронбаха равна отношению содержащейся в F истинной дисперсии к ее полной дисперсии, включающей и дисперсию статистического шума). A=Dполезн/(Dполезн+Dшума) |
| 0,1 | 0,9 | 0,0122 | 0,9878 | 0,0080 | 0,1099 | 0,0121 | 0,5819 | 0,1889 | 0,0357 | 0,0144 | 0,0237 |
| 0,2 | 0,8 | 0,0588 | 0,9412 | 0,0560 | 0,2401 | 0,0576 | 0,6108 | 0,3944 | 0,1556 | 0,0966 | 0,1511 |
| 0,3 | 0,7 | 0,1552 | 0,8448 | 0,1547 | 0,3927 | 0,1542 | 0,6606 | 0,5944 | 0,3533 | 0,2454 | 0,3545 |
| 0,4 | 0,6 | 0,3077 | 0,6923 | 0,3066 | 0,5545 | 0,3075 | 0,7333 | 0,7562 | 0,5719 | 0,4352 | 0,5702 |
| 0,5 | 0,5 | 0,5000 | 0,5000 | 0,5001 | 0,7085 | 0,5020 | 0,8165 | 0,8676 | 0,7528 | 0,6310 | 0,7501 |
| 0,6 | 0,4 | 0,6923 | 0,3077 | 0,6922 | 0,8319 | 0,6921 | 0,8915 | 0,9332 | 0,8708 | 0,7909 | 0,8709 |
| 0,7 | 0,3 | 0,8448 | 0,1552 | 0,8432 | 0,9185 | 0,8436 | 0,9463 | 0,9706 | 0,9421 | 0,8995 | 0,9416 |
Выше мы показали, что только при значениях параметра а>0,4 при количестве вопросов в шкале до 300 может быть достигнута надежность (достоверность) шкалы, равная или большая, чем 90%. Из последней таблицы видно, что значению параметра а=0,4, начиная с которого вопросы есть смысл включать в измерительную опросниковую шкалу, соответствуют такие анкетные пункты, у которых заключенная в них доля шумовой дисперсии не превосходит 0,73 (чему соответствует коэффициент вклада шума в составную из ИСТИНЫ и ШУМА переменную не выше 0,63), или, на языке других критериев, взаимная скоррелированность анкетных пунктов в анкете должна быть не ниже, чем 0,25, а их корреляция (по отдельности для каждого) с независимо известной ИСТИНОЙ (измерению которой посвящается составляемая из них шкала) должна быть не ниже, чем 0,5 (при достаточно большом количестве анкетных пунктов в измерительной шкале F, обеспечивающем ее надежность около А=0,90, этому соответствует корреляция анкетных пунктов с целостной шкалой F приблизительно не ниже, чем 0,45). Соответственно, анкетные пункты, у которых все их корреляции со всеми без исключения итогово измеренными соционическими показателями респондентов не превосходят по модулю 0,40-0,45, для включения в диагностическую часть анкет заведомо не пригодны (хотя эти пункты и могут включаться в анкеты чисто в исследовательских целях - для выявления слабых статистически взаимосвязей, но не в диагностическую часть анкет).
- Расчет альфы Кронбаха (надежности) по отдельности для шкал основных соционических показателей в социодиагностических опросниках В.Л.Таланова
Результаты расчета по формулам предыдущего подраздела приведены в следующей таблице 6:
Табл.6
| Тип диагностической анкеты: | MOLTI-1 | MOLTI-2 | MOLTI-3 | MOLTI-4 | MOLTI-5 (муж) | MOLTI-5 (жен) | MOLTI-6 | MOLTI-7 | Cреднее значение по всем версиям MOLTI | SZ-584 | NZ-584 | Cреднее значение анкет SZ и NZ | NZ-584 (диагностика по 1-й половине вопросов теста) | NZ-584 (диагностика по 2-й половине вопросов теста) | Cреднее значение для двух половин теста NZ |
| Количество диагностических вопросов, N | 270 | 270 | 244 | 244 | 210 | 210 | 222 | 222 | 588 | 588 | 292 | 292 | |||
| N/(N-1) | 1,003717 | 1,003717 | 1,004115 | 1,004115 | 1,004785 | 1,004785 | 1,004525 | 1,004525 | 1,0017 | 1,0017 | 1,00344 | 1,00344 | |||
| Число респондентов анкеты (M) | 783 | 1040 | 1769 | 1729 | 556 | 1585 | 1260 | 1200 | 958 | 867 | 867 | 867 | |||
| ИЛЭ - суммпроизв - Альфа Кронбаха | 0,919 | 0,913 | 0,912 | 0,907 | 0,896 | 0,907 | 0,897 | 0,895 | 0,906 | 0,952 | 0,951 | 0,951 | 0,915 | 0,902 | 0,908 |
| ЛИИ - суммпроизв - Альфа Кронбаха | 0,932 | 0,927 | 0,916 | 0,913 | 0,904 | 0,915 | 0,911 | 0,911 | 0,916 | 0,955 | 0,956 | 0,955 | 0,905 | 0,921 | 0,913 |
| СЭИ - суммпроизв - Альфа Кронбаха | 0,921 | 0,921 | 0,910 | 0,907 | 0,918 | 0,925 | 0,894 | 0,891 | 0,911 | 0,957 | 0,956 | 0,956 | 0,916 | 0,915 | 0,915 |
| ЭСЭ - суммпроизв - Альфа Кронбаха | 0,910 | 0,903 | 0,909 | 0,906 | 0,871 | 0,904 | 0,887 | 0,897 | 0,898 | 0,946 | 0,949 | 0,948 | 0,905 | 0,902 | 0,903 |
| СЛЭ - суммпроизв - Альфа Кронбаха | 0,937 | 0,937 | 0,916 | 0,921 | 0,925 | 0,933 | 0,913 | 0,911 | 0,924 | 0,961 | 0,962 | 0,962 | 0,925 | 0,929 | 0,927 |
| ЛСИ - суммпроизв - Альфа Кронбаха | 0,934 | 0,929 | 0,921 | 0,924 | 0,909 | 0,919 | 0,918 | 0,913 | 0,921 | 0,961 | 0,963 | 0,962 | 0,933 | 0,926 | 0,929 |
| ИЭИ - суммпроизв - Альфа Кронбаха | 0,919 | 0,912 | 0,921 | 0,923 | 0,908 | 0,915 | 0,914 | 0,907 | 0,915 | 0,955 | 0,960 | 0,957 | 0,927 | 0,918 | 0,923 |
| ЭИЭ - суммпроизв - Альфа Кронбаха | 0,915 | 0,915 | 0,909 | 0,909 | 0,909 | 0,905 | 0,906 | 0,896 | 0,908 | 0,954 | 0,957 | 0,955 | 0,921 | 0,913 | 0,917 |
| СЭЭ - суммпроизв - Альфа Кронбаха | 0,942 | 0,941 | 0,916 | 0,916 | 0,921 | 0,928 | 0,918 | 0,915 | 0,925 | 0,960 | 0,957 | 0,958 | 0,909 | 0,923 | 0,916 |
| ЭСИ - суммпроизв - Альфа Кронбаха | 0,933 | 0,927 | 0,908 | 0,905 | 0,913 | 0,918 | 0,902 | 0,900 | 0,913 | 0,960 | 0,957 | 0,958 | 0,923 | 0,915 | 0,919 |
| ИЛИ - суммпроизв - Альфа Кронбаха | 0,917 | 0,907 | 0,909 | 0,907 | 0,882 | 0,908 | 0,899 | 0,902 | 0,904 | 0,946 | 0,952 | 0,949 | 0,906 | 0,908 | 0,907 |
| ЛИЭ - суммпроизв - Альфа Кронбаха | 0,906 | 0,905 | 0,897 | 0,892 | 0,896 | 0,904 | 0,896 | 0,897 | 0,899 | 0,942 | 0,941 | 0,942 | 0,899 | 0,876 | 0,888 |
| ИЭЭ - суммпроизв - Альфа Кронбаха | 0,939 | 0,935 | 0,925 | 0,927 | 0,914 | 0,921 | 0,922 | 0,916 | 0,925 | 0,964 | 0,964 | 0,964 | 0,934 | 0,928 | 0,931 |
| ЭИИ - суммпроизв - Альфа Кронбаха | 0,939 | 0,940 | 0,919 | 0,922 | 0,929 | 0,936 | 0,915 | 0,913 | 0,927 | 0,962 | 0,963 | 0,963 | 0,927 | 0,930 | 0,929 |
| СЛИ - суммпроизв - Альфа Кронбаха | 0,931 | 0,927 | 0,912 | 0,913 | 0,912 | 0,915 | 0,915 | 0,909 | 0,917 | 0,957 | 0,956 | 0,956 | 0,920 | 0,910 | 0,915 |
| ЛСЭ - суммпроизв - Альфа Кронбаха | 0,907 | 0,901 | 0,910 | 0,910 | 0,895 | 0,906 | 0,903 | 0,901 | 0,904 | 0,948 | 0,954 | 0,951 | 0,913 | 0,911 | 0,912 |
| Среднее значение альфы Кронбаха в профиле 16 психотипов | 0,9251 | 0,9213 | 0,9131 | 0,9127 | 0,9064 | 0,9162 | 0,9069 | 0,9045 | 0,913 | 0,955 | 0,956 | 0,956 | 0,917 | 0,914 | 0,916 |
| Стандартное отклонение альфы Кронбаха в профиле 16 психотипов | 0,0118 | 0,0130 | 0,0066 | 0,0087 | 0,0148 | 0,0099 | 0,0100 | 0,0079 | 0,0091 | 0,0063 | 0,0057 | 0,0058 | 0,0103 | 0,0131 | 0,0108 |
| ЭКСТРАВЕРТ - суммпроизв - Альфа Кронбаха | 0,949 | 0,946 | 0,925 | 0,927 | 0,934 | 0,938 | 0,929 | 0,927 | 0,934 | 0,966 | 0,965 | 0,965 | 0,929 | 0,933 | 0,931 |
| ИРРАЦИОНАЛ - суммпроизв - Альфа Кронбаха | 0,921 | 0,917 | 0,882 | 0,885 | 0,892 | 0,895 | 0,885 | 0,882 | 0,895 | 0,953 | 0,950 | 0,951 | 0,899 | 0,911 | 0,905 |
| СТАТИК - суммпроизв - Альфа Кронбаха | 0,872 | 0,863 | 0,771 | 0,762 | 0,863 | 0,883 | 0,783 | 0,770 | 0,821 | 0,890 | 0,904 | 0,897 | 0,800 | 0,842 | 0,821 |
| ИНТУИТ - суммпроизв - Альфа Кронбаха | 0,915 | 0,904 | 0,921 | 0,921 | 0,902 | 0,916 | 0,908 | 0,904 | 0,911 | 0,955 | 0,962 | 0,959 | 0,933 | 0,919 | 0,926 |
| РАССУДИТ - суммпроизв - Альфа Кронбаха | 0,923 | 0,928 | 0,854 | 0,860 | 0,915 | 0,920 | 0,876 | 0,876 | 0,894 | 0,956 | 0,955 | 0,956 | 0,909 | 0,919 | 0,914 |
| ТАКТИК - суммпроизв - Альфа Кронбаха | 0,821 | 0,817 | 0,714 | 0,696 | 0,762 | 0,804 | 0,776 | 0,781 | 0,771 | 0,853 | 0,865 | 0,859 | 0,732 | 0,794 | 0,763 |
| БЕСПЕЧН - суммпроизв - Альфа Кронбаха | 0,740 | 0,741 | 0,468 | 0,464 | 0,678 | 0,712 | 0,727 | 0,726 | 0,657 | 0,812 | 0,828 | 0,820 | 0,677 | 0,733 | 0,705 |
| ЛОГИК - суммпроизв - Альфа Кронбаха | 0,923 | 0,918 | 0,929 | 0,928 | 0,896 | 0,912 | 0,917 | 0,914 | 0,917 | 0,961 | 0,962 | 0,961 | 0,930 | 0,924 | 0,927 |
| ВЕСЕЛЫЙ - суммпроизв - Альфа Кронбаха | 0,855 | 0,843 | 0,754 | 0,748 | 0,816 | 0,822 | 0,791 | 0,751 | 0,798 | 0,901 | 0,895 | 0,898 | 0,813 | 0,804 | 0,808 |
| КОНСТРУКТИВИСТ - суммпроизв - Альфа Кронбаха | 0,910 | 0,903 | 0,810 | 0,800 | 0,859 | 0,879 | 0,860 | 0,855 | 0,859 | 0,901 | 0,918 | 0,909 | 0,832 | 0,863 | 0,847 |
| УСТУПЧ - суммпроизв - Альфа Кронбаха | 0,791 | 0,815 | 0,661 | 0,644 | 0,816 | 0,822 | 0,747 | 0,748 | 0,756 | 0,886 | 0,893 | 0,890 | 0,793 | 0,817 | 0,805 |
| КВЕСТИМ - суммпроизв - Альфа Кронбаха | 0,759 | 0,768 | 0,748 | 0,754 | 0,775 | 0,784 | 0,741 | 0,726 | 0,757 | 0,815 | 0,865 | 0,840 | 0,757 | 0,765 | 0,761 |
| ДЕМОКРАТ - суммпроизв - Альфа Кронбаха | 0,871 | 0,864 | 0,817 | 0,800 | 0,788 | 0,827 | 0,830 | 0,837 | 0,829 | 0,897 | 0,910 | 0,904 | 0,818 | 0,848 | 0,833 |
| ПОЗИТИВИСТ - суммпроизв - Альфа Кронбаха | 0,896 | 0,890 | 0,705 | 0,695 | 0,828 | 0,845 | 0,825 | 0,817 | 0,813 | 0,878 | 0,889 | 0,883 | 0,760 | 0,829 | 0,794 |
| ПРОЦЕСС - суммпроизв - Альфа Кронбаха | 0,874 | 0,878 | 0,741 | 0,749 | 0,841 | 0,855 | 0,765 | 0,765 | 0,808 | 0,919 | 0,918 | 0,918 | 0,801 | 0,877 | 0,839 |
| БИ - суммпроизв - Альфа Кронбаха | 0,902 | 0,898 | 0,913 | 0,911 | 0,897 | 0,907 | 0,895 | 0,894 | 0,902 | 0,951 | 0,957 | 0,954 | 0,925 | 0,909 | 0,917 |
| ЧИ - суммпроизв - Альфа Кронбаха | 0,929 | 0,923 | 0,915 | 0,917 | 0,907 | 0,918 | 0,908 | 0,905 | 0,915 | 0,958 | 0,962 | 0,960 | 0,932 | 0,923 | 0,928 |
| БС - суммпроизв - Альфа Кронбаха | 0,917 | 0,917 | 0,905 | 0,905 | 0,915 | 0,917 | 0,898 | 0,892 | 0,908 | 0,955 | 0,956 | 0,956 | 0,923 | 0,907 | 0,915 |
| ЧС - суммпроизв - Альфа Кронбаха | 0,933 | 0,932 | 0,913 | 0,915 | 0,917 | 0,929 | 0,909 | 0,907 | 0,919 | 0,958 | 0,962 | 0,960 | 0,923 | 0,929 | 0,926 |
| БЛ - суммпроизв - Альфа Кронбаха | 0,928 | 0,922 | 0,927 | 0,925 | 0,897 | 0,912 | 0,918 | 0,915 | 0,918 | 0,959 | 0,960 | 0,960 | 0,924 | 0,922 | 0,923 |
| ЧЛ - суммпроизв - Альфа Кронбаха | 0,916 | 0,913 | 0,923 | 0,922 | 0,897 | 0,908 | 0,913 | 0,908 | 0,912 | 0,958 | 0,960 | 0,959 | 0,926 | 0,920 | 0,923 |
| БЭ - суммпроизв - Альфа Кронбаха | 0,920 | 0,918 | 0,923 | 0,921 | 0,907 | 0,919 | 0,909 | 0,908 | 0,916 | 0,959 | 0,959 | 0,959 | 0,924 | 0,918 | 0,921 |
| ЧЭ - суммпроизв - Альфа Кронбаха | 0,930 | 0,923 | 0,927 | 0,926 | 0,895 | 0,912 | 0,919 | 0,916 | 0,918 | 0,961 | 0,961 | 0,961 | 0,928 | 0,923 | 0,925 |
| БК - суммпроизв - Альфа Кронбаха | 0,932 | 0,927 | 0,897 | 0,897 | 0,912 | 0,918 | 0,902 | 0,902 | 0,911 | 0,954 | 0,954 | 0,954 | 0,898 | 0,919 | 0,909 |
| ЧК - суммпроизв - Альфа Кронбаха | 0,900 | 0,899 | 0,879 | 0,881 | 0,894 | 0,906 | 0,876 | 0,881 | 0,890 | 0,935 | 0,941 | 0,938 | 0,873 | 0,896 | 0,885 |
| БД - суммпроизв - Альфа Кронбаха | 0,931 | 0,928 | 0,901 | 0,904 | 0,907 | 0,911 | 0,908 | 0,903 | 0,912 | 0,951 | 0,949 | 0,950 | 0,908 | 0,899 | 0,904 |
| ЧД - суммпроизв - Альфа Кронбаха | 0,888 | 0,883 | 0,850 | 0,844 | 0,859 | 0,876 | 0,882 | 0,881 | 0,870 | 0,906 | 0,909 | 0,907 | 0,828 | 0,834 | 0,831 |
При расчете альфы Кронбаха для соционических признаков и функций использовался не их вторичный расчет через готовый типный профиль, а непосредственное их измерение, аналогичное процедуре измерения типных нагрузок в типном профиле. Для этого вычислялись суммы произведений последовательности нормированных ответов каждого респондента на последовательность соответствующих этим вопросам диагностических коэффициентов, в свою очередь рассчитанных для признаков и функций по таблицам 1 и2, исходя из матрицы типных диагностических коэффициентов.
Как видно из таблицы 6, для большинства соционических показателей (включая все показатели психотипов) условие превышения 90% надежности выполняется – даже для сравнительно коротких опросников серии MOLTI, содержащих сравнительно немного диагностических вопросов. Для больших опросников (NZ-584, SZ-584) надежность определения типных показателей в среднем превышает 95%, а для опросников серии MOLTI средняя надежность при измерении типных показателей равна 91%. Наименее надежным показателем для всех исследованных опросников оказывается шкала беспечности-предусмотрительности – ее надежность для опросников MOLTI составила в среднем лишь 66%, а для больших опросников – 82%. Если же учесть то, что шкала беспечности отчасти скоррелирована с другими, более сильными признаковыми шкалами, то надежность определения «чистой» беспечности, свободной от этих влияний и полностью ортогональной к прочим признакам, может получаться еще ниже.
Высокое значение коэффициента «альфа» Кронбаха указывает на наличие общего основания у набора вопросов каждой соответствующей измерительной шкалы (что порождает достаточно высокую скоррелированность этих вопросов между собой). В принципе, это основание может представлять собой и не один фактор, а сумму нескольких факторов. Что это за основание, и насколько оно совпадает с озаглавленным в названии шкалы, коэффициент Кронбаха, естественно, не проясняет – для этого требуются исследования шкалы на ее валидность. Однако с учетом того, что диагностические коэффициенты опросников Таланова формируются исключительно на основе обучающих выборок людей, ранее заявивших свой психотип и ответивших на соответствующие анкетные вопросы, можно уже однозначно утверждать, что А>0,95 для шкалы, измеряющей, например, выраженность маркерных качеств ИЛЭ, означает, что эта измерительная шкала по своей дисперсии более чем на 95% совпадает с теми свойствами, которые обнаруживаются при усреднении психологических качеств очень большого количества людей, считающих себя представителями типа ИЛЭ, и которые отличают в среднем эту группу считающих себя «ИЛЭ» людей от среднепопуляционного уровня. Тем самым сочетание высокой надежности по Кронбаху с «фасадной» или «лицевой» (еще говорят - «очевидной») валидностью, которая автоматически вытекает уже из самого способа формирования измерительной шкалы, указывает также и на несомненную высокую конструктную валидность каждой такой шкалы в задаче количественного измерения выраженности у индивидуума синдромокомплекса тех особенных свойств, которые присущи группе людей, объединенных в соционической культуре по признаку их принадлежности к определенному сектору психологического пространства, условно называемому психотипом.
- Надежность всех отдельных соционических показателей, измеряемых психодиагностическими анкетами В.Л.Таланова, по методу расщепления теста пополам («метод автономных частей»)
В диагностических опросниках Таланова серии MOLTI-330 расщепление тестовых вопросов на две половины, с целью текущего контроля надежности ответов каждого респондента, заложено изначально. При этом вопросы двух половин следуют в тесте вперемешку, а отбор вопросов в каждую половину выполнен таким образом, чтобы характеристики диагностических коэффициентов (особенно их стандартное отклонение для каждого диагностируемого ТИМа) в обеих половинах теста были максимально близки. В «больших» опросниках NZ-584 и SZ-584 разбиение диагностических вопросов на две независимые половины выполняется формально – в качестве первой половины берутся вопросы теста с нумерацией от 1 до 292, в качестве второй половины теста – вопросы с номерами от 293 до 584. Поскольку вопросы в тесте при этом хорошо случайным образом перемешаны, поэтому диагностические характеристики «первой» и «второй» половин теста также оказываются достаточно сходными. Естественно, что во всех случаях (и для MOLTI, и для анкет NZ и SZ) вопросы в двух половинах теста сугубо разные, не повторяются.
Табл. 7. Линейные корреляции между соционическими показателями, независимо измеренными по двум половинам теста в опросниках серии MOLTI (для составления таблицы результаты по всем первым семи версиям опросников серии MOLTI были объединены). Расчет на основе “сырых” типных профилей респондентов - без приведения их к одинаковому единичному стандартному отклонению. Во всех ячейках таблицы, за исключением ее первой строки (где приведена сходимость двух полученных типных диагнозов), приведены линейные корреляции между показателями, полученными независимо по двум половинам теста.
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | |
|---|---|---|---|---|---|---|---|---|---|---|
| Все респонденты | Все мужчины | Все женщины | Респонденты младше 20 лет | Респонденты с возрастом от 20 до 25 лет | Респонденты с возрастом от 26 до 30 лет | Респонденты старших возрастных групп (старше 30 лет) | «Первичные респонденты» - Респонденты, заявившие самый минимальный уровень знакомства с соционикой (=1) и притом не указавшие свой тип | Все респонденты, заявившие высокий уровень знакомства с соционикой (3 или 4) - включая как не указавших, так и указавших свой тип с любой величиной его вероятности | Респонденты, заявившие высокий уровень знакомства с соционикой (3 или 4) и притом указавшие свой тип с субъективной оценкой его вероятности не ниже 50% | |
| число респондентов | 9922 | 2654 | 7268 | 4694 | 2458 | 1287 | 1483 | 3560 | 1553 | 1300 |
| Доля совпадения диагноза типа (то есть доля совпадения самого высокого пика профиля) при расчете типных профилей независимо по двум половинам теста | 0,579 | 0,557 | 0,588 | 0,576 | 0,592 | 0,578 | 0,570 | 0,515 | 0,679 | 0,699 |
| Высота типного профиля респондента (стандартное отклонение в наборе 16-ти функций Фишера от корреляций между ответами этого респондента и диагностическими коэффициентами типов). Начиная с этой строки (и далее) в таблице указываются корреляции между соответствующими показателями, полученными по двум разным половинам теста. | 0,77 | 0,77 | 0,77 | 0,76 | 0,76 | 0,78 | 0,78 | 0,74 | 0,77 | 0,77 |
| ИЛЭ | 0,84 | 0,83 | 0,84 | 0,82 | 0,84 | 0,84 | 0,86 | 0,81 | 0,87 | 0,87 |
| ЛИИ | 0,87 | 0,87 | 0,87 | 0,87 | 0,87 | 0,88 | 0,88 | 0,84 | 0,89 | 0,90 |
| СЭИ | 0,83 | 0,82 | 0,83 | 0,83 | 0,83 | 0,83 | 0,83 | 0,81 | 0,84 | 0,85 |
| ЭСЭ | 0,83 | 0,80 | 0,84 | 0,83 | 0,82 | 0,83 | 0,84 | 0,82 | 0,84 | 0,83 |
| СЛЭ | 0,88 | 0,88 | 0,88 | 0,89 | 0,87 | 0,87 | 0,88 | 0,85 | 0,91 | 0,91 |
| ЛСИ | 0,89 | 0,89 | 0,88 | 0,88 | 0,89 | 0,88 | 0,89 | 0,85 | 0,91 | 0,91 |
| ИЭИ | 0,87 | 0,87 | 0,87 | 0,87 | 0,87 | 0,87 | 0,87 | 0,83 | 0,91 | 0,92 |
| ЭИЭ | 0,86 | 0,84 | 0,86 | 0,85 | 0,87 | 0,86 | 0,86 | 0,84 | 0,89 | 0,89 |
| СЭЭ | 0,88 | 0,88 | 0,89 | 0,88 | 0,88 | 0,89 | 0,89 | 0,86 | 0,90 | 0,90 |
| ЭСИ | 0,84 | 0,83 | 0,85 | 0,82 | 0,85 | 0,86 | 0,86 | 0,82 | 0,87 | 0,87 |
| ИЛИ | 0,86 | 0,84 | 0,86 | 0,86 | 0,85 | 0,85 | 0,86 | 0,83 | 0,87 | 0,88 |
| ЛИЭ | 0,80 | 0,79 | 0,80 | 0,79 | 0,80 | 0,82 | 0,81 | 0,76 | 0,83 | 0,83 |
| ИЭЭ | 0,89 | 0,88 | 0,89 | 0,88 | 0,89 | 0,89 | 0,89 | 0,85 | 0,90 | 0,90 |
| ЭИИ | 0,89 | 0,87 | 0,89 | 0,89 | 0,88 | 0,88 | 0,88 | 0,87 | 0,91 | 0,91 |
| СЛИ | 0,85 | 0,84 | 0,85 | 0,84 | 0,86 | 0,86 | 0,86 | 0,83 | 0,88 | 0,88 |
| ЛСЭ | 0,84 | 0,84 | 0,85 | 0,84 | 0,83 | 0,84 | 0,86 | 0,81 | 0,89 | 0,89 |
| Усредненная по всем 16-ти психотипам корреляция результатов двух половин теста | 0,858 | 0,848 | 0,859 | 0,853 | 0,856 | 0,859 | 0,864 | 0,830 | 0,882 | 0,885 |
| ЭКСТРАВЕРТ | 0,90 | 0,90 | 0,90 | 0,90 | 0,90 | 0,91 | 0,90 | 0,89 | 0,91 | 0,92 |
| ИРРАЦИОНАЛ | 0,83 | 0,82 | 0,83 | 0,82 | 0,82 | 0,83 | 0,85 | 0,80 | 0,84 | 0,85 |
| СТАТИК | 0,60 | 0,60 | 0,59 | 0,60 | 0,58 | 0,60 | 0,65 | 0,55 | 0,68 | 0,68 |
| ИНТУИТ | 0,87 | 0,87 | 0,87 | 0,85 | 0,87 | 0,87 | 0,88 | 0,83 | 0,91 | 0,91 |
| РАССУДИТ | 0,86 | 0,85 | 0,86 | 0,85 | 0,86 | 0,84 | 0,84 | 0,84 | 0,87 | 0,87 |
| ТАКТИК | 0,51 | 0,49 | 0,50 | 0,51 | 0,49 | 0,54 | 0,54 | 0,47 | 0,55 | 0,55 |
| БЕСПЕЧН | 0,48 | 0,44 | 0,49 | 0,48 | 0,47 | 0,52 | 0,49 | 0,45 | 0,54 | 0,54 |
| ЛОГИК | 0,89 | 0,88 | 0,89 | 0,89 | 0,89 | 0,89 | 0,90 | 0,86 | 0,92 | 0,92 |
| ВЕСЕЛЫЙ | 0,67 | 0,65 | 0,67 | 0,65 | 0,67 | 0,63 | 0,68 | 0,62 | 0,75 | 0,76 |
| КОНСТРУКТИВИСТ | 0,76 | 0,73 | 0,77 | 0,76 | 0,76 | 0,75 | 0,77 | 0,73 | 0,75 | 0,77 |
| УСТУПЧ | 0,63 | 0,62 | 0,64 | 0,65 | 0,62 | 0,55 | 0,61 | 0,64 | 0,63 | 0,63 |
| КВЕСТИМ | 0,47 | 0,43 | 0,48 | 0,46 | 0,42 | 0,51 | 0,52 | 0,45 | 0,45 | 0,44 |
| ДЕМОКРАТ | 0,63 | 0,65 | 0,62 | 0,62 | 0,64 | 0,62 | 0,64 | 0,56 | 0,73 | 0,74 |
| ПОЗИТИВИСТ | 0,70 | 0,69 | 0,70 | 0,69 | 0,72 | 0,69 | 0,71 | 0,66 | 0,73 | 0,74 |
| ПРОЦЕСС | 0,70 | 0,68 | 0,70 | 0,70 | 0,69 | 0,68 | 0,68 | 0,67 | 0,71 | 0,72 |
| БИ | 0,85 | 0,84 | 0,86 | 0,84 | 0,85 | 0,85 | 0,86 | 0,83 | 0,89 | 0,89 |
| ЧИ | 0,87 | 0,88 | 0,87 | 0,86 | 0,88 | 0,88 | 0,88 | 0,84 | 0,91 | 0,91 |
| БС | 0,84 | 0,83 | 0,84 | 0,82 | 0,85 | 0,84 | 0,84 | 0,81 | 0,86 | 0,86 |
| ЧС | 0,89 | 0,89 | 0,89 | 0,89 | 0,88 | 0,88 | 0,88 | 0,86 | 0,92 | 0,92 |
| БЛ | 0,89 | 0,88 | 0,89 | 0,89 | 0,89 | 0,89 | 0,89 | 0,86 | 0,91 | 0,91 |
| ЧЛ | 0,88 | 0,86 | 0,87 | 0,88 | 0,87 | 0,87 | 0,88 | 0,83 | 0,90 | 0,91 |
| БЭ | 0,87 | 0,85 | 0,87 | 0,87 | 0,87 | 0,87 | 0,87 | 0,84 | 0,90 | 0,90 |
| ЧЭ | 0,89 | 0,87 | 0,89 | 0,89 | 0,89 | 0,88 | 0,89 | 0,86 | 0,91 | 0,91 |
| БК | 0,81 | 0,81 | 0,81 | 0,81 | 0,80 | 0,82 | 0,83 | 0,77 | 0,84 | 0,85 |
| ЧК | 0,78 | 0,76 | 0,79 | 0,79 | 0,77 | 0,78 | 0,77 | 0,75 | 0,82 | 0,82 |
| БД | 0,82 | 0,80 | 0,82 | 0,81 | 0,82 | 0,80 | 0,83 | 0,79 | 0,83 | 0,84 |
| ЧД | 0,71 | 0,70 | 0,72 | 0,70 | 0,69 | 0,75 | 0,74 | 0,69 | 0,73 | 0,73 |
Из приведенной таблицы видно, что женщины в сравнении с мужчинами, а также более старшие лица по сравнению с более молодыми, дают чуть более высокие показатели надежности диагностируемых соционических показателей (выше корреляции между двумя половинками теста). Очевидно, это происходит в первом случае за счет более высокой средней мотивированности и старательности при заполнении тестов, а в отношении возрастной тенденции – по причине накопления жизненного опыта и углублении представлений о своих свойствах в сравнении с другими людьми. Однако различия между всеми половыми и возрастными группами все же очень малы и безусловно не являются критичными. Аналогично, не являются критичными даже и несколько более существенные различия между полными новичками в соционике (лицами, в своем большинстве впервые столкнувшимися с соционикой и социодиагностикой, столбик 8) и лицами, твердо знающими свой психотип и давно знакомыми с соционикой (столбик 9). Таким образом, знание так называемых «соционических стереотипов» если и оказывает влияние на заполнение соционических опросников, то это влияние достаточно слабо и не является критичным для результатов опросников.
Среди соционических признаков сравнительно слабую надежность, измеренную по методу расщепления опросника, показывают, как и в случае измерения надежности методом Кронбаха, признаки беспечности и квестимности. Среди шкал психотипов самые низкие показатели надежности (при измерении надежности любым методом – как по Кронбаху, так и методом расщепления) показывают шкалы ЭСЭ и ЛИЭ. Это, очевидно, связано с тем, что именно эти два психотипа реже всего встречаются среди респондентов социодиагностических анкет, а потому и диагностические коэффициенты для определения этих типов получены на меньших по объему выборках и оттого несколько более зашумлены.
Скоррелированность между собою двух показателей надежности (измеренных по методу Кронбаха и по методу расщепления) составляет для опросников MOLTI величину 0,92 при коррелировании на профиле соционических признаков, и величину 0,85 при коррелировании на профиле социотипов. Таким образом, две разные оценки надежности тесно взаимосвязаны.
Следует учитывать, что представленная в последней таблице надежность соционических показателей, измеренная как корреляция между соответствующими результатами двух половин теста, может быть завышена за счет влияния на все корреляции общего для них несоционического или, вернее, не вполне соционического фактора – а именно, индивидуально получающейся высоты типного профиля. Чтобы исключить влияние этого не вполне соционического фактора на надежность (внутреннюю согласованность) соционических показателей, представим далее аналогичную предыдущей таблицу, в которой перед расчетом корреляций соционические профили всех испытуемых полностью скорректированы на высоту типного профиля. Это значит, что все типные профили (полученные как по первой, так и по второй половине анкет) сначала нормируются к одинаковому для всех респондентов единичному стандартному отклонению (приобретая тем самым одинаковый размах), а уже после этого вычисляются корреляции между соционическими показателями двух половин теста. Сходимость диагнозов эта процедура не затрагивает, однако все корреляции могут (и должны) измениться в сторону некоторого уменьшения, в итоге более адекватно отражая чисто соционическую сторону надежности:
Табл. 8. Корреляции между соционическими показателями, независимо измеренными по двум половинам теста в опросниках серии MOLTI (для составления таблицы результаты по всем первым семи версиям опросников серии MOLTI были объединены). Расчет на основе типных профилей респондентов, приведенных к одинаковому единичному стандартному отклонению перед расчетом корреляций между показателями двух половин теста. Во всех ячейках таблицы, за исключением ее первой строки (где приведена сходимость двух полученных типных диагнозов), приведены линейные корреляции между показателями, полученными независимо по двум половинам теста.
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | |
|---|---|---|---|---|---|---|---|---|---|---|
| Все респонденты | Все мужчины | Все женщины | Респонденты младше 20 лет | Респонденты с возрастом от 20 до 25 лет | Респонденты с возрастом от 26 до 30 лет | Респонденты старших возрастных групп (старше 30 лет) | Респонденты, заявившие самый минимальный уровень знакомства с соционикой (=1) и притом не указавшие свой тип | Все респонденты, заявившие высокий уровень знакомства с соционикой (3 или 4) - включая как не указавших, так и указавших свой тип с любой величиной его вероятности | Респонденты, заявившие высокий уровень знакомства с соционикой (3 или 4) и притом указавшие свой тип с субъективной оценкой его вероятности не ниже 50% | |
| число респондентов | 9922 | 2654 | 7268 | 4694 | 2458 | 1287 | 1483 | 3560 | 1553 | 1300 |
| Доля совпадения диагноза типа (то есть доля совпадения самого высокого пика профиля) при расчете типных профилей независимо по двум половинам теста | 0,579 | 0,557 | 0,588 | 0,576 | 0,592 | 0,578 | 0,570 | 0,515 | 0,679 | 0,699 |
| ИЛЭ | 0,80 | 0,78 | 0,81 | 0,78 | 0,80 | 0,82 | 0,83 | 0,79 | 0,83 | 0,84 |
| ЛИИ | 0,84 | 0,83 | 0,84 | 0,83 | 0,84 | 0,85 | 0,85 | 0,80 | 0,88 | 0,89 |
| СЭИ | 0,79 | 0,77 | 0,80 | 0,79 | 0,79 | 0,79 | 0,80 | 0,78 | 0,81 | 0,82 |
| ЭСЭ | 0,80 | 0,76 | 0,81 | 0,80 | 0,80 | 0,80 | 0,81 | 0,79 | 0,81 | 0,81 |
| СЛЭ | 0,84 | 0,83 | 0,85 | 0,85 | 0,84 | 0,83 | 0,84 | 0,81 | 0,89 | 0,89 |
| ЛСИ | 0,85 | 0,84 | 0,85 | 0,85 | 0,85 | 0,85 | 0,86 | 0,81 | 0,89 | 0,90 |
| ИЭИ | 0,84 | 0,82 | 0,84 | 0,83 | 0,84 | 0,83 | 0,83 | 0,79 | 0,89 | 0,89 |
| ЭИЭ | 0,83 | 0,81 | 0,83 | 0,81 | 0,84 | 0,84 | 0,82 | 0,80 | 0,87 | 0,87 |
| СЭЭ | 0,85 | 0,84 | 0,85 | 0,85 | 0,85 | 0,85 | 0,84 | 0,82 | 0,88 | 0,88 |
| ЭСИ | 0,80 | 0,78 | 0,81 | 0,78 | 0,81 | 0,82 | 0,82 | 0,77 | 0,83 | 0,84 |
| ИЛИ | 0,82 | 0,80 | 0,83 | 0,83 | 0,82 | 0,82 | 0,82 | 0,80 | 0,85 | 0,86 |
| ЛИЭ | 0,75 | 0,74 | 0,75 | 0,74 | 0,74 | 0,77 | 0,77 | 0,70 | 0,78 | 0,79 |
| ИЭЭ | 0,85 | 0,84 | 0,86 | 0,85 | 0,85 | 0,85 | 0,86 | 0,82 | 0,88 | 0,89 |
| ЭИИ | 0,85 | 0,83 | 0,86 | 0,86 | 0,85 | 0,84 | 0,84 | 0,83 | 0,89 | 0,89 |
| СЛИ | 0,82 | 0,80 | 0,82 | 0,80 | 0,83 | 0,82 | 0,83 | 0,79 | 0,86 | 0,87 |
| ЛСЭ | 0,80 | 0,78 | 0,80 | 0,79 | 0,78 | 0,80 | 0,81 | 0,76 | 0,85 | 0,86 |
| Усредненная по всем 16-ти психотипам корреляция результатов двух половин теста | 0,822 | 0,804 | 0,826 | 0,816 | 0,820 | 0,823 | 0,827 | 0,791 | 0,857 | 0,861 |
| ЭКСТРАВЕРТ | 0,89 | 0,88 | 0,90 | 0,89 | 0,89 | 0,89 | 0,89 | 0,88 | 0,91 | 0,91 |
| ИРРАЦИОНАЛ | 0,79 | 0,78 | 0,80 | 0,78 | 0,78 | 0,80 | 0,79 | 0,77 | 0,79 | 0,80 |
| СТАТИК | 0,49 | 0,48 | 0,48 | 0,48 | 0,46 | 0,50 | 0,55 | 0,44 | 0,61 | 0,61 |
| ИНТУИТ | 0,84 | 0,84 | 0,85 | 0,83 | 0,85 | 0,85 | 0,85 | 0,81 | 0,91 | 0,91 |
| РАССУДИТ | 0,81 | 0,80 | 0,82 | 0,81 | 0,82 | 0,80 | 0,79 | 0,80 | 0,84 | 0,84 |
| ТАКТИК | 0,42 | 0,39 | 0,41 | 0,41 | 0,40 | 0,47 | 0,44 | 0,37 | 0,47 | 0,48 |
| БЕСПЕЧН | 0,38 | 0,34 | 0,40 | 0,38 | 0,36 | 0,42 | 0,40 | 0,35 | 0,44 | 0,44 |
| ЛОГИК | 0,88 | 0,84 | 0,88 | 0,88 | 0,88 | 0,88 | 0,88 | 0,84 | 0,90 | 0,90 |
| ВЕСЕЛЫЙ | 0,55 | 0,53 | 0,56 | 0,54 | 0,55 | 0,54 | 0,56 | 0,50 | 0,68 | 0,68 |
| КОНСТРУКТИВИСТ | 0,66 | 0,62 | 0,68 | 0,66 | 0,65 | 0,66 | 0,68 | 0,62 | 0,69 | 0,71 |
| УСТУПЧ | 0,54 | 0,55 | 0,54 | 0,56 | 0,52 | 0,49 | 0,51 | 0,55 | 0,53 | 0,53 |
| КВЕСТИМ | 0,41 | 0,36 | 0,42 | 0,40 | 0,34 | 0,46 | 0,45 | 0,37 | 0,37 | 0,35 |
| ДЕМОКРАТ | 0,54 | 0,54 | 0,54 | 0,53 | 0,55 | 0,55 | 0,53 | 0,48 | 0,66 | 0,67 |
| ПОЗИТИВИСТ | 0,60 | 0,57 | 0,62 | 0,59 | 0,62 | 0,61 | 0,60 | 0,56 | 0,65 | 0,65 |
| ПРОЦЕСС | 0,58 | 0,55 | 0,59 | 0,59 | 0,57 | 0,55 | 0,58 | 0,56 | 0,62 | 0,63 |
| БИ | 0,82 | 0,81 | 0,83 | 0,80 | 0,82 | 0,82 | 0,83 | 0,80 | 0,87 | 0,87 |
| ЧИ | 0,85 | 0,84 | 0,85 | 0,84 | 0,85 | 0,85 | 0,85 | 0,81 | 0,89 | 0,89 |
| БС | 0,81 | 0,79 | 0,81 | 0,78 | 0,82 | 0,81 | 0,81 | 0,79 | 0,85 | 0,86 |
| ЧС | 0,86 | 0,86 | 0,86 | 0,86 | 0,86 | 0,85 | 0,85 | 0,82 | 0,91 | 0,91 |
| БЛ | 0,86 | 0,84 | 0,87 | 0,86 | 0,86 | 0,87 | 0,87 | 0,83 | 0,89 | 0,89 |
| ЧЛ | 0,85 | 0,81 | 0,85 | 0,85 | 0,85 | 0,84 | 0,85 | 0,80 | 0,88 | 0,88 |
| БЭ | 0,84 | 0,81 | 0,85 | 0,84 | 0,84 | 0,85 | 0,85 | 0,81 | 0,88 | 0,88 |
| ЧЭ | 0,87 | 0,84 | 0,87 | 0,87 | 0,88 | 0,86 | 0,87 | 0,84 | 0,89 | 0,90 |
| БК | 0,73 | 0,73 | 0,73 | 0,72 | 0,72 | 0,75 | 0,75 | 0,67 | 0,79 | 0,80 |
| ЧК | 0,69 | 0,67 | 0,70 | 0,71 | 0,68 | 0,71 | 0,67 | 0,66 | 0,74 | 0,74 |
| БД | 0,74 | 0,71 | 0,75 | 0,74 | 0,73 | 0,73 | 0,75 | 0,70 | 0,76 | 0,77 |
| ЧД | 0,63 | 0,60 | 0,64 | 0,63 | 0,59 | 0,67 | 0,64 | 0,61 | 0,65 | 0,66 |
В этой последней таблице средние показатели надежности (по скоррелированности показателей половин теста) несколько уменьшились по сравнению с аналогичными данными предпоследней таблицы – как и предполагалось. Это произошло за счет очищения от общего не вполне соционического фактора высоты типного профиля, обусловленного не только истинно соционической контрастностью выраженности у респондентов функций их психики, но также разным уровнем жизненного опыта респондентов и их разной старательности при прохождении теста. Также немного увеличились различия в надежности между соционическими новичками и опытными социониками (при определении типов – 0,791 и 0,857 соответственно), однако по-прежнему эти различия не достигают уровня критически важных, которые бы указывали на неспособность людей без соционического или психологического опыта получить в социодиагностическом тесте надежные результаты. На это обстоятельство – независимость соционической диагностики по анкете от наличия или отсутствия прошлого соционического опыта – указывает и достаточно высокая сходимость диагнозов социотипа, независимо полученных по двум разным половникам анкеты для лиц без какого-либо соционического опыта (k=0,515).
- Индивидуальные показатели надежности психодиагностического теста для конкретного индивидуума-респондента
В отличие от выше рассмотренных выборочных показателей надежности (характеризующих среднюю надежность на достаточно большой выборке испытуемых), индивидуальные показатели надежности зависят не только от объективного наличия в каждом диагностическом вопросе, помимо статистического шума, той или иной доли дисперсии измеряемой психологической величины (чем её больше – тем всегда лучше), но также и от сугубо индивидуальной способности и ситуативного желания респондента эту компоненту важного психологического свойства в анкетном вопросе увидеть и почувствовать. Например, у нас есть два вопроса с близким смыслом, соответствующим экстравертным чертам: 1) Люблю много двигаться; 2) Часто активно жестикулирую. Если респонденты вдумываются в смысл этих вопросов и понимают этот смысл, если они способны соотнести его со своим жизненным опытом, то ответы на оба этих вопроса окажутся в выборке респондентов высоко и положительно скоррелированными между собою. Что же касается одного отдельного респондента, то он чаще на оба вопроса будет одновременно отвечать либо «да», либо «нет». Однако если в качестве респондентов анкеты мы возьмем обезьян или очень маленьких детей, лишь только научившихся говорить, то ни точного улавливания смысла этих вопросов, ни тем более правильного соотнесения этого смысла с жизненным опытом мы у таких респондентов не получим. Не получим мы в результате и достоверных корреляций на всей выборке между ответами на эти два примерных вопроса. Надежность результатов вообще по любым шкалам опросника для этих последних, «некомпетентных» респондентов получится всегда очень низкой, поскольку их ответы совершенно независимо от смысловой адекватности и смысловой насыщенности анкетных вопросов будут почти случайными. Таким образом, показатели индивидуальной надежности результатов опросника зависят не только от параметров самой анкеты (длины ее шкал, ясности и смысловой насыщенности вопросов), но и от индивидуальных качеств респондента – его интеллекта, его жизненного опыта, его мотивации к установлению истины при прохождении теста (а значит, и его старательности при обдумывании вопросов).
Наилучшими показателями для количественной характеристики результирующей индивидуальной надежности пройденного человеком теста, учитывающей все факторы – и качество анкеты, и интеллект, и старательность респондента, являются в случае социодиагностических опросников два показателя. Первый – это высота получающегося типного профиля (то есть стандартное отклонение 16-ти алгебраических чисел, получающихся у респондента в качестве пиков его типного профиля). Этот показатель и любые математически связанные с ним производные показатели можно рассматривать как аналог выборочной надежности, измеряемой по методу Кронбаха. Это самый точный показатель итоговой надежности для любых соционических результатов, получаемых при заполнении теста. Второй показатель, несколько менее точный (теряющий часть информации), но при этом более наглядный – это коэффициент линейной корреляции между двумя типными профилями испытуемого (то есть между двумя последовательностями из 16 алгебраических чисел), где один типный профиль получен по одной половинке заполненного респондентом теста (то есть с использованием лишь одной половины всех диагностических вопросов), а другой типный профиль получен с помощью второй независимой половинки теста.
Сначала рассмотрим первый показатель, высоту типного профиля. Будем обозначать эту величину как S.
S=стандотклон(f1;f2;f3;…f16), где f1 – фишер(корреляция ответов респондента с диагностическими коэффициентами типа ИЛЭ); f2 –тоже самое для типа ЛИИ; и так далее для всех 16-ти психотипов.
Дисперсия типного профиля: D=S^2
Получающуюся у респондента величину S можно использовать и непосредственно как относительную меру надежности получаемых индивидуальных соционичесвких результатов, соотнося ее со средневыборочной S. Но можно придать ей и точный количественный смысл, количественно точно характеризующий надежность полученного у респондента типного профиля, если вспомнить формулу Кронбаха, согласно которой надежность A= полезная дисперсия/полная дисперсия.
Полную дисперсию типного профиля мы уже знаем, это как раз измеренная у респондента величина D=S^2
Чтобы найти необходимую нам для расчета по формуле Кронбаха полезную дисперсию, надо из полной дисперсии вычесть дисперсию, обусловленную статистическим шумом. Чисто аналитическим способом рассчитать шумовую дисперсию в данном случае не просто, но легко найти ее методом математического моделирования, заменив все согласованные ответы респондентов в анкете чисто случайными числами, удовлетворяющим тем же статистическим характеристикам распределения, что и натуральные ответы респондента. В этом случае окончательно полученная дисперсия типного профиля как раз и будет равняться искомой шумовой дисперсии. Конечно, для получения более точного ее значения придется ее усреднить по нескольким десяткам расчетных случаев. Но важно, что для конкретного опросника эта усредненная шумовая дисперсия всегда константная величина, зависящая лишь от самой анкеты (причем не очень сильно зависящая), а от выбора испытуемого вообще не зависящая. Поэтому, чтобы ею далее пользоваться (например, для всех анкет серии MOLTI), достаточно рассчитать ее методом математико-статистического моделирования один единственный раз.
Сделав это для анкеты MOLTI-8, мы получили, что шумовая дисперсия типного профиля, усредненная по 70 модельным случаям, равняется 0,0051 (+/- 0,0005). Таким образом, для анкет серии MOLTI надежность получающегося типного профиля определяется по формуле: A= (S^2-0,0051)/ (S^2)
Для 750 респондентов MOLTI-8 средняя надежность A (вычисленная по только что приведенной формуле) для их полученных по анкете типных профилей составила 0,869 с медианой 0,906, со стандартным отклонением этого показателя в выборке равным 0,133 и с максимальным его значением на выборке 0,977.
Ниже приводим таблицу 9, удобную для перевода высоты (стандартного отклонения) типного профиля S в коэффициент надежности типного профиля А для встречающегося на практике диапазона изменения S у респондентов:
Табл.9
| S | A | S | A | S | A | ||
|---|---|---|---|---|---|---|---|
| 0,08 | 0,203 | 0,23 | 0,904 | 0,38 | 0,965 | ||
| 0,09 | 0,370 | 0,24 | 0,911 | 0,39 | 0,966 | ||
| 0,10 | 0,490 | 0,25 | 0,918 | 0,40 | 0,968 | ||
| 0,11 | 0,579 | 0,26 | 0,925 | 0,41 | 0,970 | ||
| 0,12 | 0,646 | 0,27 | 0,930 | 0,42 | 0,971 | ||
| 0,13 | 0,698 | 0,28 | 0,935 | 0,43 | 0,972 | ||
| 0,14 | 0,740 | 0,29 | 0,939 | 0,44 | 0,974 | ||
| 0,15 | 0,773 | 0,30 | 0,943 | 0,45 | 0,975 | ||
| 0,16 | 0,801 | 0,31 | 0,947 | 0,46 | 0,976 | ||
| 0,17 | 0,824 | 0,32 | 0,950 | 0,47 | 0,977 | ||
| 0,18 | 0,843 | 0,33 | 0,953 | 0,48 | 0,978 | ||
| 0,19 | 0,859 | 0,34 | 0,956 | 0,49 | 0,979 | ||
| 0,20 | 0,873 | 0,35 | 0,958 | 0,50 | 0,980 | ||
| 0,21 | 0,884 | 0,36 | 0,961 | ||||
| 0,22 | 0,895 | 0,37 | 0,963 |
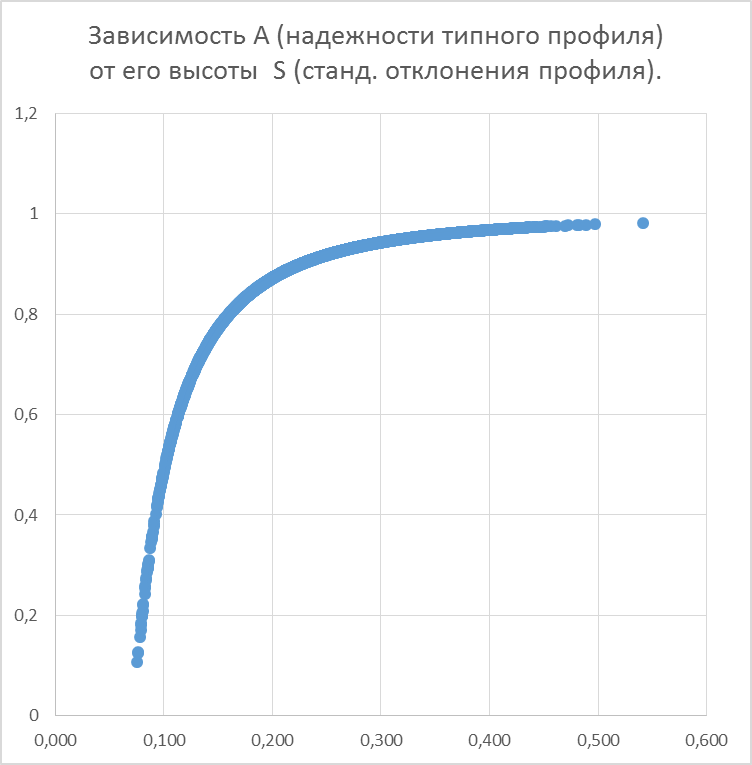
Рис.1
- Сходимость психотипа по самотипированию и психотипа по анкетному диагнозу в зависимости от индивидуальных показателей надежности теста у респондентов
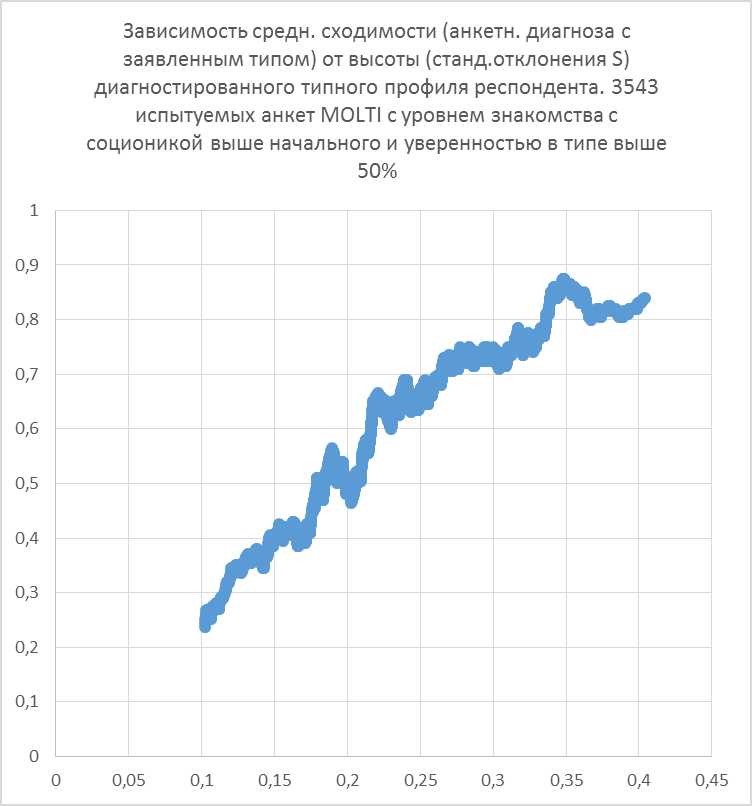
Рис. 2. Усреднение каждой точки графика по 200 испытуемым, смежным по величине S. Выборка 3543 испытуемых, заявивших свой тип с уверенностью выше 50%, и притом с уровнем знакомства с соционикой выше начального.
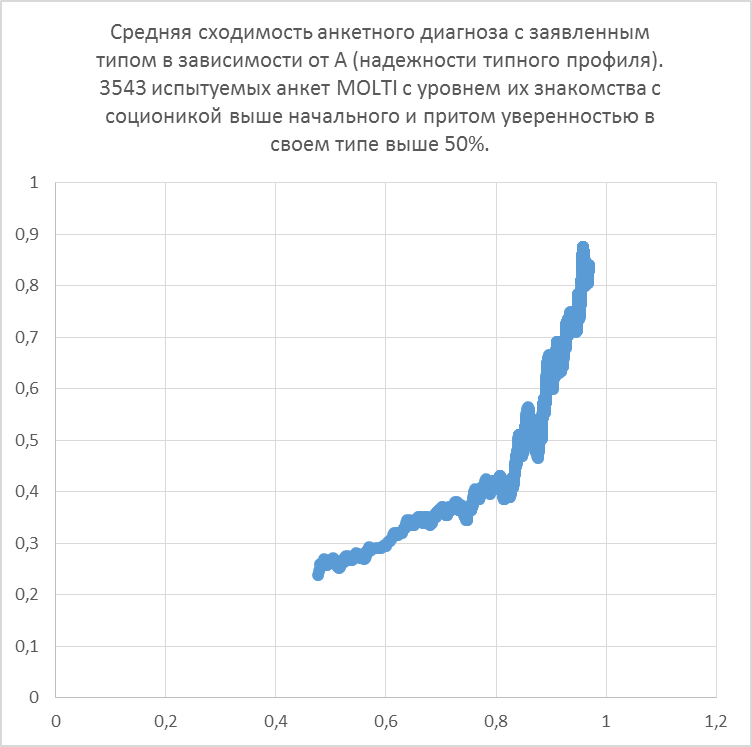
Рис. 3. Усреднение каждой точки графика по 200 испытуемым, смежным по величине А. Выборка 3543 испытуемых, заявивших свой тип с уверенностью выше 50%, и притом с уровнем знакомства с соционикой выше начального.
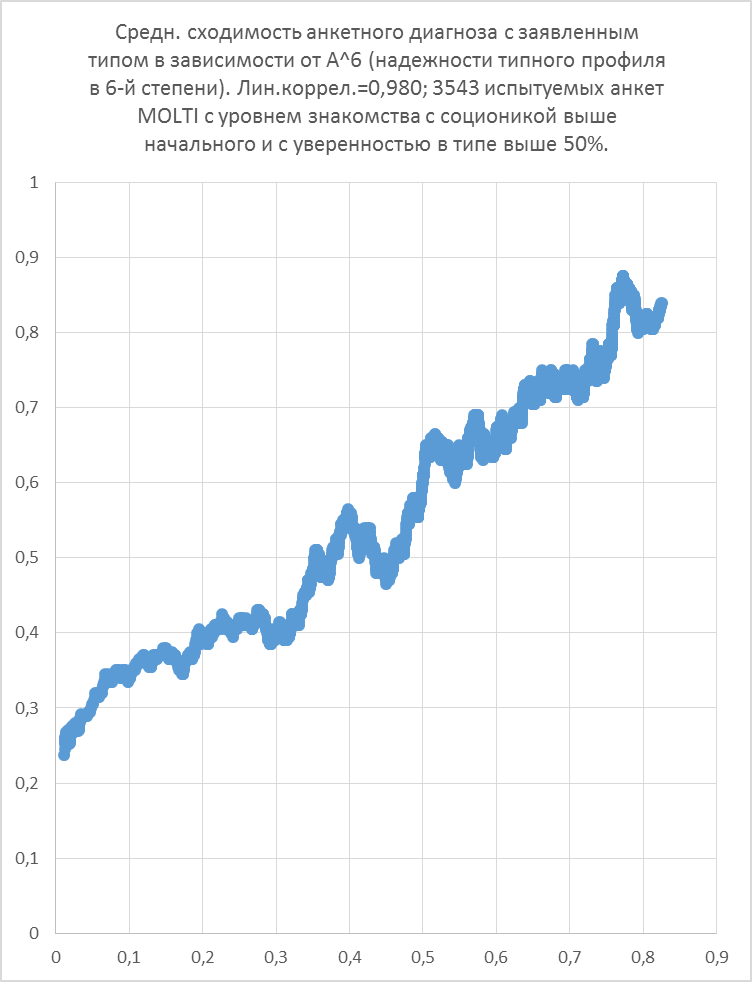
Рис. 4. Усреднение каждой точки графика по 200 испытуемым, смежным по величине А. Выборка 3543 испытуемых, заявивших свой тип с уверенностью выше 50%, и притом с уровнем знакомства с соционикой выше начального.
Пусть h1, h2, h3 – соответственно высоты 1-го (главного), 2-го и 3-го пиков диагностированного типного профиля. Из общих соображений понятно, что чем сильнее главный пик по своей высоте отличается от следующих за ним по высоте пиков, то есть чем ближе испытуемый находится к центру, а не к границам своего типа, тем больше должен быть показатель сходимости двух диагнозов – анкетного и по самотипированию. Это должно происходить по двум причинам. Во-первых, для лиц, являющихся по своему типу «не пограничными», более точным и надежным становится диагноз их самотипирования. Во-вторых, по той же причине чаще попадает «в свой тип» и анкетный диагноз – большого различия по высоте между главным пиком и второстепенными оказывается в таком случае достаточно, чтобы сохранить лидирующее положение «главного» пика даже при наложении на него и второстепенные пики добавочного стохастического (случайного) шума, порождаемого несовершенствами анкетной диагностики. Но это пока лишь гипотеза, которая нуждается в проверке.
Для ее проверки составим для каждого анкетного профиля функцию f=(h1+c2*h2+c3*h3)/h1, где c2, c3 – пока что неизвестные алгебраические числа (постоянные коэффициенты, веса в формуле двух последующих пиков профиля). Наша задача – найти такие значения этих двух коэффициентов в характеризующей форму профиля (и не связанной с его высотою) функции f, при которых ее корреляция со сходимостью диагнозов, анкетного и по самотипированию, достигает максимума. Эта задача решается программными средствами EXCEL (подбор параметров решения для максимизации заданного критерия). Решение показывает, что c2 и c3 – и в самом деле отрицательные числа, причем максимум корреляции функции f со сходимостью диагнозов (равной 1 или 0) на выборке 5790 респондентов анкет MOLTI с заявленными по самотипированию типами равен R=0,373 и достигается при f=(h1-0,425*h2-0,353*h3)/h1
С ростом f растет взаимная сходимость анкетного диагноза и диагноза по самотипированию (рис.5; 7), а также растет уверенность испытуемых в своем типе по самотипированию (рис.6; 8):
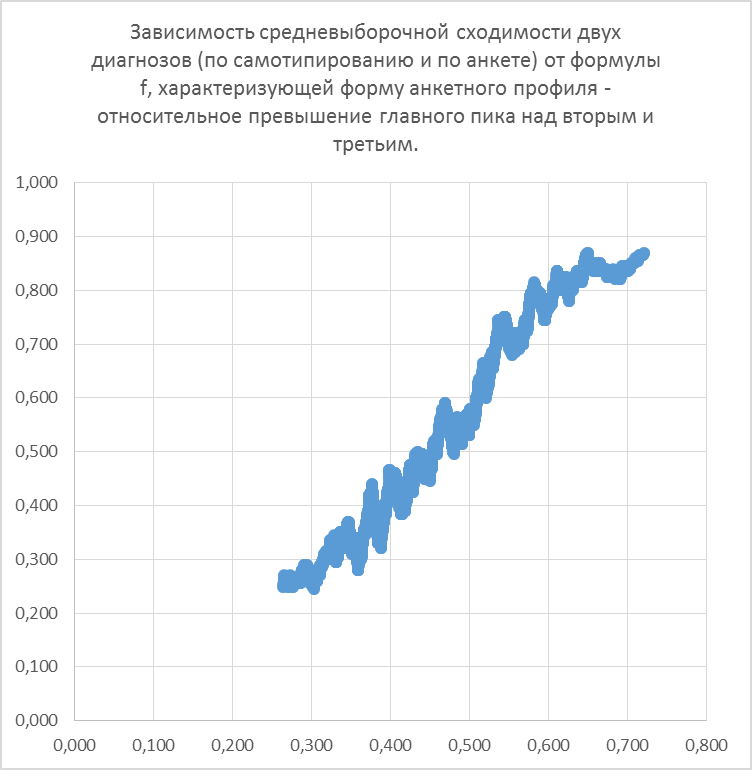
Рис. 5. Усреднение каждой точки графика по 200 испытуемым, смежным по величине f. При построении графика использованы данные всех 5790 респондентов MOLTI, заявивших свой тип (независимо от их уровня знакомства с соционикой и процента уверенности в своем типе).
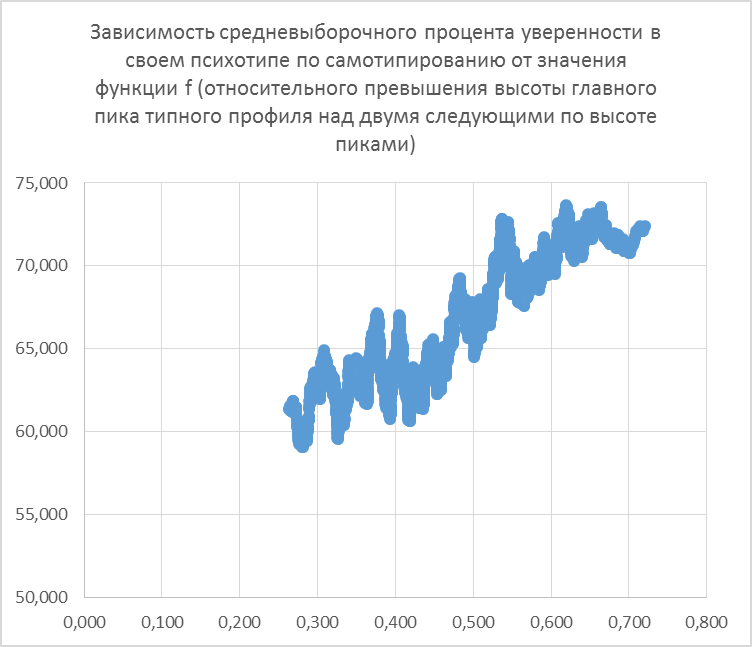
Рис. 6. Усреднение каждой точки графика по 200 испытуемым, смежным по величине f. При построении графика использованы данные всех 5790 респондентов MOLTI, заявивших свой тип (независимо от их уровня знакомства с соционикой и процента уверенности в своем типе).
Графики получаются еще более контрастными по виду зависимостей, если для построения их точек оставить только испытуемых с уровнем знакомства с соционикой выше начального (то есть в кодировке анкет MOLTI – с уровнем знакомства с соционикой =2; 3; 4)
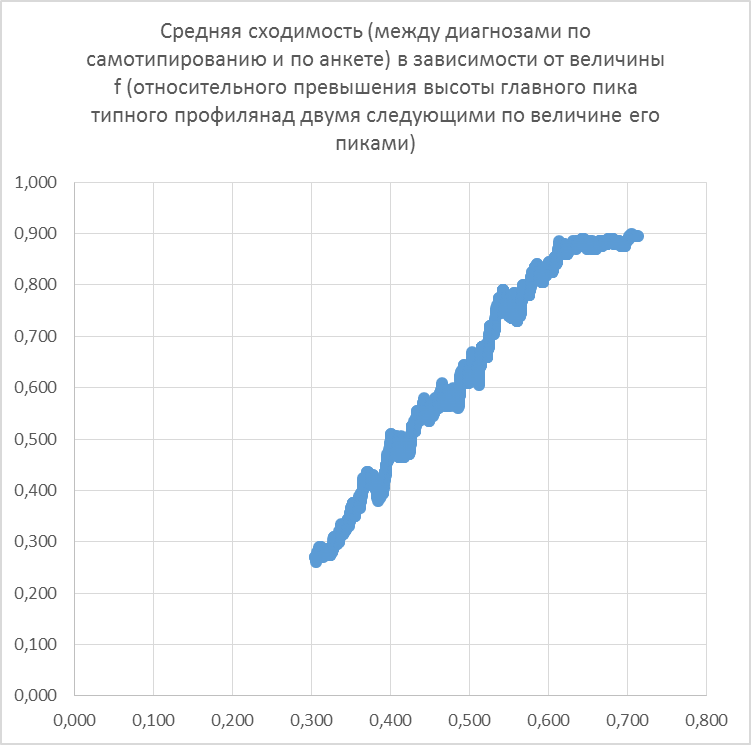
Рис. 7. Усреднение каждой точки графика по 200 испытуемым, смежным по величине f. При построении графика использованы данные 4053 респондентов MOLTI, заявивших свой тип и указавших уровень знакомства с соционикой выше начального. Сначала с ростом f (функции контрастности преобладания главного пика профиля над второстепенными) сходимость диагнозов растет линейно, увеличиваясь с 0,26 до 0,89, но выходит на плато (=0,9) начиная с f=0,62.
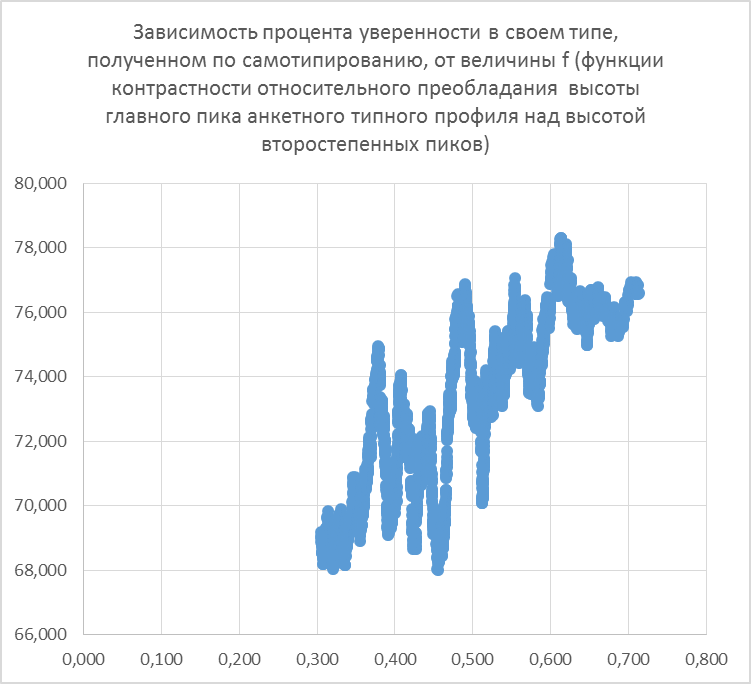
Рис. 8. Усреднение каждой точки графика по 200 испытуемым, смежным по величине f. При построении графика использованы данные 4053 респондентов MOLTI, заявивших свой тип и указавших уровень знакомства с соционикой выше начального. С ростом f (функции контрастности преобладания главного пика профиля над второстепенными) средняя уверенность испытуемых в своем типе возрастает от 69% до 77%.
Если из сходимости диагнозов по самотипированию и по анкете исключить сильное влияние на эту сходимость величины f (функции контрастности преобладания главного пика типного профиля над второстепенными пиками, характеризующей близость испытуемого к центру типного сектора), то скорректированная на эту корреляцию величина сходимости от формы профиля зависеть уже больше не будет, но останется ее зависимость от общей высоты профиля (стандартного отклонения S, рассчитанного по 16 числам профиля), а соответственно также и от надежности профиля А, являющейся непосредственной функцией от S. В этом случае по-прежнему, как и на рис 4, линейная зависимость получается между средней сходимостью и шестой степенью надежности А (см. следующий рис.9):.
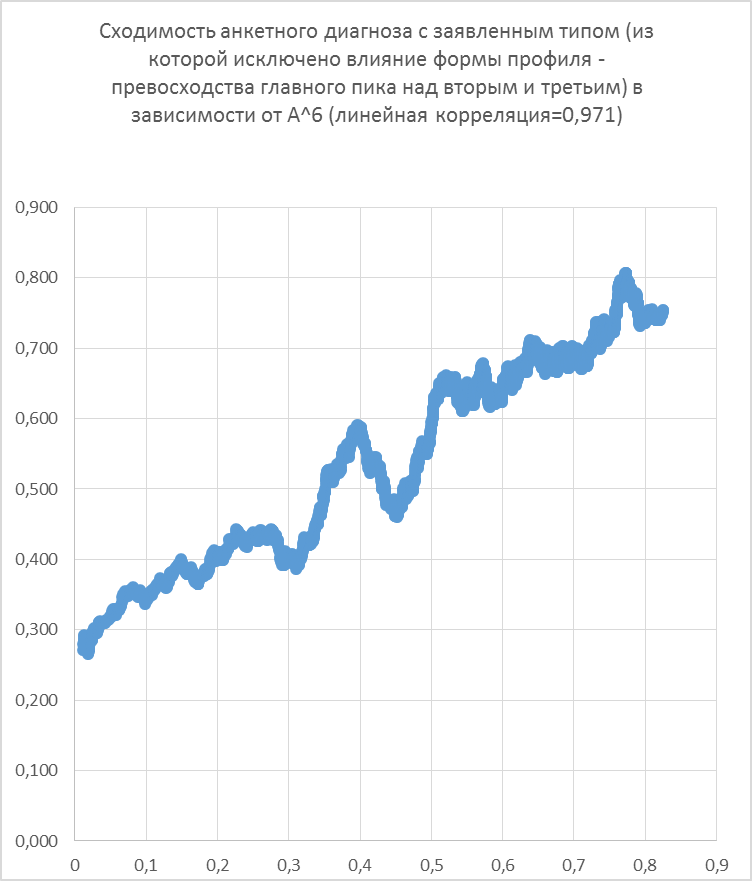
Рис. 9. Усреднение каждой точки графика по 200 испытуемым, смежным по величине А. 3543 испытуемых анкет MOLTI с уровнем знакомства с соционикой выше начального и притом с уверенностью в своем типе выше 50%. Из сходимости предварительно исключено влияние на нее формы профиля, выражаемой функцией f.
Таким образом, на сходимость диагнозов по самотипированию и по анкете влияют два независимых фактора. Первый фактор выражается функцией f, которая характеризует форму типного профиля испытуемого, относительное преобладание главного пика профиля над второстепенными. Чем больше функция f, тем более испытуемый приближен к центру своего типного сектора и удален от его границ, где диагноз (как по самотипированию, так и по анкете) становится неустойчивым. Второй влияющий на сходимость фактор, практически не зависящий от первого, выражается шестой степенью надежности типного профиля, которая в свою очередь рассчитывается по стандартному отклонению типного профиля. Этот второй фактор характеризует лишь индивидуальный уровень надежности ответов испытуемого в анкете (а частично – также и надежность его самотипирования) и комплексно растет в зависимости от его интеллекта, жизненного опыта, психологической компетентности и мотивированности (старательности).
Эти два влияющих на сходимость фактора можно просуммировать, чтобы получить итоговую функцию, объясняющую максимум дисперсии в сходимости диагнозов (по самотипированию и анкетного). С учетом разного стандартного отклонения функций, характеризующих эти два фактора (разброс f в 2,2 раза уже, чем разброс А, что должно быть скомпенсировано домножением f на 2,2), эта оптимальная факторная комбинация (обозначим ее Z) равна: Z= A^6+2,2*f-0,45 = ((S^2-0,0051)/ (S^2))^6+2,2*(h1-0,425*h2-0,353*h3)/h1-0,45 ; где S – стандартное отклонение набора чисел в каждом индивидуальном полученном по анкете типном профиле; h1, h2, h3 – высоты трех наибольших пиков этого профиля в порядке убывания. Весовой коэффициент 2,2 перед вторым фактором обусловлен различиями в корреляции каждого из факторов со сходимостью и в величине стандартного отклонения выражающих их функций (первый фактор скоррелирован со сходимостью на уровне 0,322, а второй 0,373, соответственно сигма первого фактора 0,217, а второго 0,113). Свободный член (-0,45) введен для того, чтобы приблизить минимальное значение суммы факторов к нулю.
На массиве всех респондентов анкет MOLTI, заявивших свой тип по самотипированию (5790 человек) показатель Z имеет линейную корреляцию со сходимостью двух типных диагнозов (по самотипированию и по анкете, со значением 1 либо 0), равную 0,460. Для корреляции непрерывной величины с бинарно распределенным показателем (принимающем дискретные значения 1 либо 0) это очень и очень высокое значение коэффициента линейной корреляции.
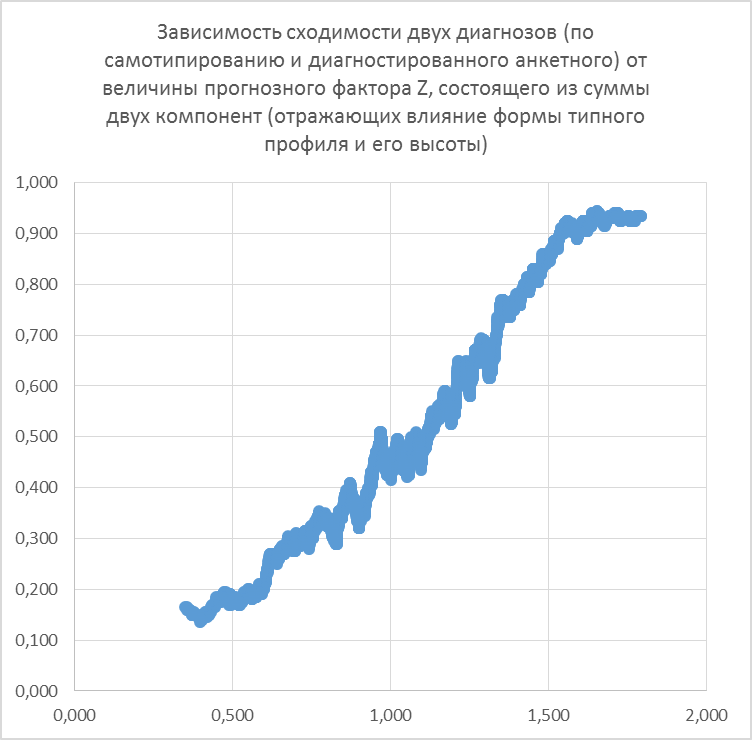
Рис. 10. Усреднение каждой точки графика по 200 испытуемым, смежным по величине Z. При построении графика использованы данные всех 5790 респондентов MOLTI, заявивших свой тип (независимо от их уровня знакомства с соционикой и процента уверенности в своем типе).
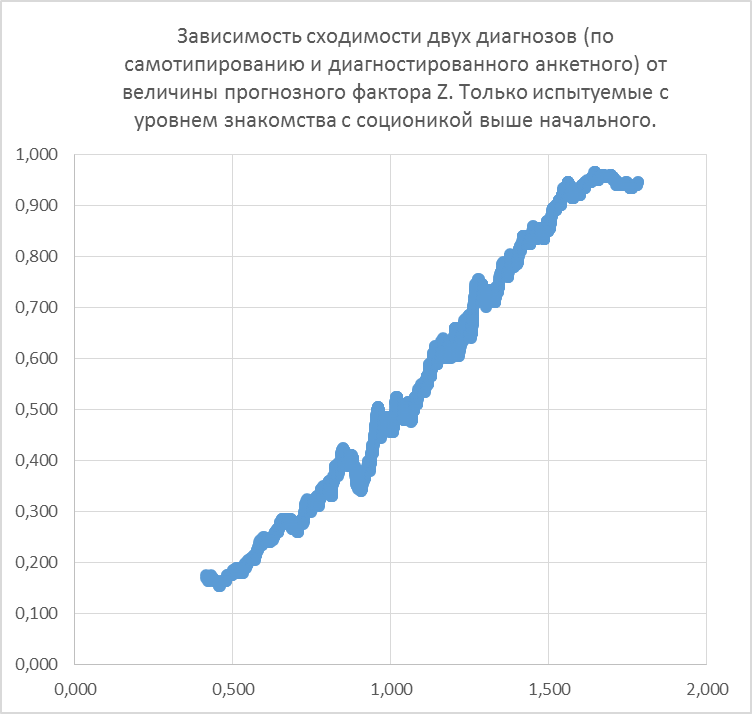
Рис. 11. Усреднение каждой точки графика по 200 испытуемым, смежным по величине Z. При построении графика использованы данные 4053 респондентов MOLTI, заявивших свой тип и имеющих уровень знакомства с соционикой выше начального.
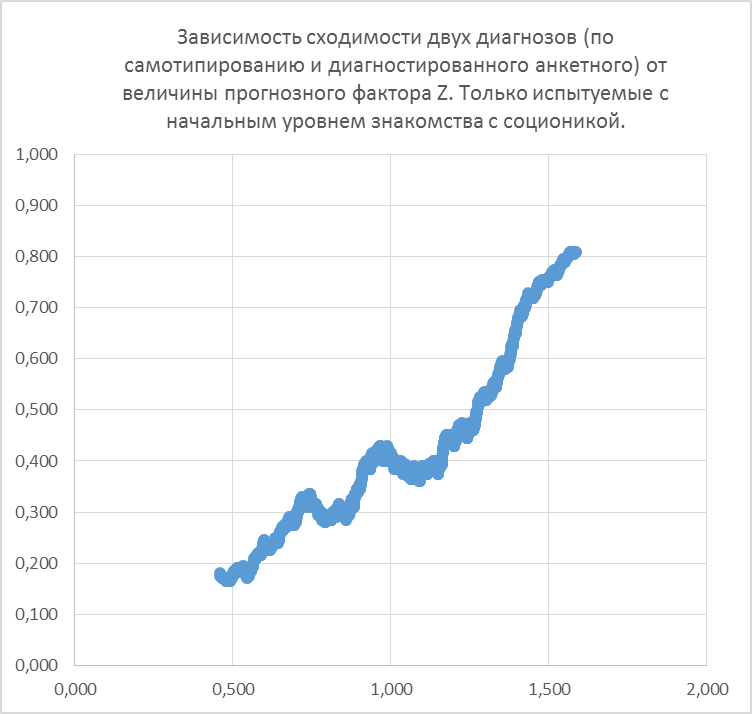
Рис. 12. Усреднение каждой точки графика по 200 испытуемым, смежным по величине Z. При построении графика использованы данные 1737 респондентов MOLTI, заявивших свой тип и имеющих начальный (минимальный) уровень знакомства с соционикой.
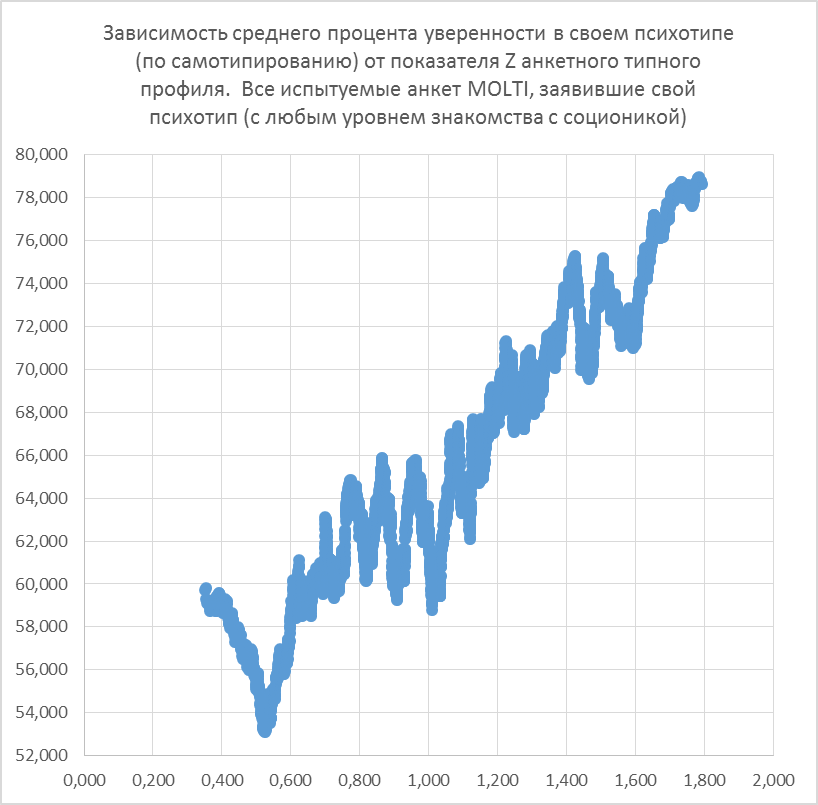
Рис.13. Усреднение каждой точки графика по 200 испытуемым, смежным по величине Z. При построении графика использованы данные всех 5790 респондентов MOLTI, заявивших свой тип (независимо от их уровня знакомства с соционикой и процента уверенности в своем типе).
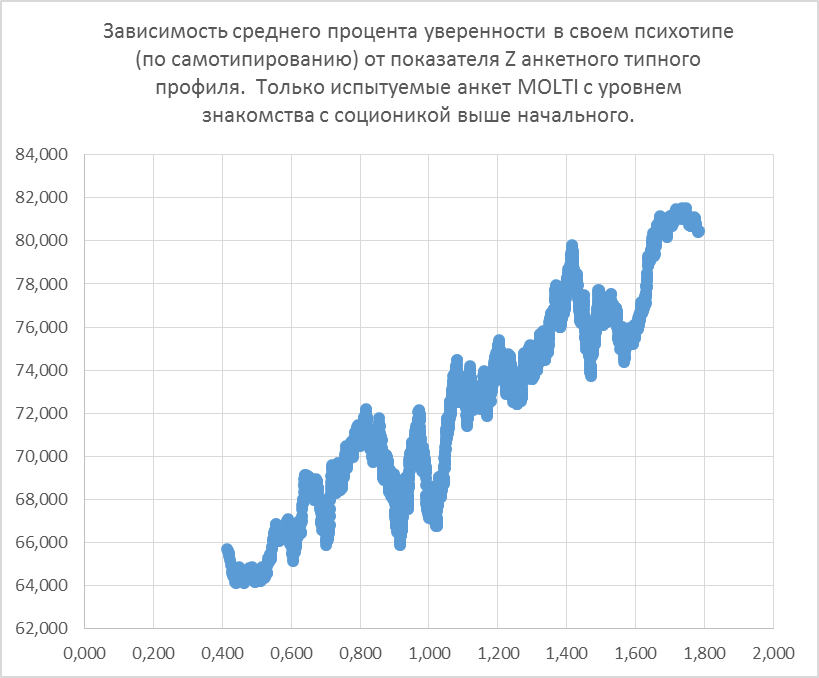
Рис. 14. Усреднение каждой точки графика по 200 испытуемым, смежным по величине Z. При построении графика использованы данные 4053 респондентов MOLTI, заявивших свой тип и имеющих уровень знакомства с соционикой выше начального.
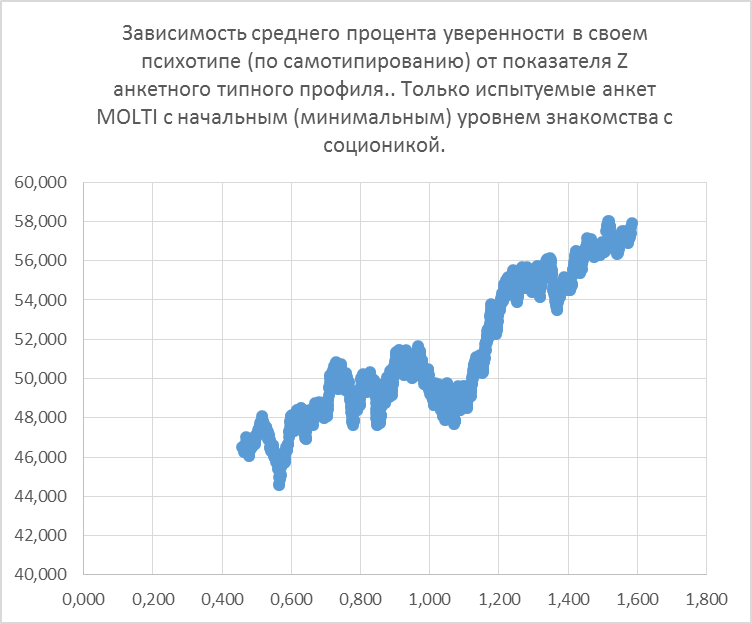
Рис. 15. Усреднение каждой точки графика по 200 испытуемым, смежным по величине Z. При построении графика использованы данные 1737 респондентов MOLTI, заявивших свой тип и имеющих начальный (минимальный) уровень знакомства с соционикой.
- Сходимость психотипа по самотипированию и психотипа по анкетному диагнозу в зависимости от пола, возраста и соционического опыта респондентов
Табл.10
| Пол | N (число респондентов) | сходимость |
|---|---|---|
| 1=муж | 2654 | 0,549 |
| 2=жен | 7268 | 0,551 |
| Возрастной диапазон | N | сходимость |
| 1 | 4694 | 0,531 |
| 2 | 2458 | 0,567 |
| 3 | 1287 | 0,567 |
| 4 | 1001 | 0,566 |
| 5 | 482 | 0,577 |
| Уровень знакомства с соционикой (от 1 до 4) | N | сходимость |
| 1 | 5297 | 0,417 |
| 2 | 3072 | 0,566 |
| 3 | 1316 | 0,697 |
| 4 | 237 | 0,652 |
| вероятность ТИМа по самооценке (в процентах) | N | сходимость |
| 0 | 192 | 0,427 |
| 5 | 57 | 0,246 |
| 10 | 48 | 0,271 |
| 15 | 42 | 0,310 |
| 20 | 81 | 0,358 |
| 25 | 59 | 0,424 |
| 30 | 156 | 0,333 |
| 35 | 74 | 0,324 |
| 40 | 198 | 0,343 |
| 45 | 88 | 0,341 |
| 50 | 859 | 0,447 |
| 55 | 94 | 0,521 |
| 60 | 354 | 0,506 |
| 65 | 203 | 0,483 |
| 70 | 570 | 0,537 |
| 75 | 340 | 0,597 |
| 80 | 592 | 0,633 |
| 85 | 325 | 0,674 |
| 90 | 513 | 0,704 |
| 95 | 508 | 0,699 |
| 100 | 437 | 0,705 |
Большинство зависимостей сходимости, показанных в таблице, вполне предсказуемы и понятны. Мужчины и женщины различаются по сходимости мало, но все же у девушек/женщин сходимость чуть выше, что легко объяснить их более высокой мотивированностью при типировании (вполне предсказуемой - так как у женщин более высокий интерес к отношениям, созданию и укреплению семьи, подбору для себя оптимального брачного партнера и т.п.). С возрастом сходимость возрастает, хотя и не очень существенно (с возрастом жизненный психологический опыт, нужный для адекватных самооценок, накапливается, но при этом умные все равно остаются умными, а дураки – дураками, а это деление уже никак не связано с возрастом и гораздо сильнее влияет на качество как самотипирования, так и заполнения анкет). С ростом уровня знакомства с соционикой сходимость диагнозов довольно существенно возрастает – однако в самой казалось бы, профессиональной группе, группе соционических «гуру» (237 человек) опять несколько снижается (вероятно, это происходит по той причине, что чрезмерная самоуверенность не всегда дружит с адекватностью). С ростом уверенности в своем заявленном типе показатели сходимости также закономерно и вполне понятным образом монотонно возрастают.
- Различия сходимости и показателей надежности типного профиля в зависимости от заявленного психотипа – факты и анализ причин. Основные влияющие факторы.
Табл.11.
| Таблица некоторых усредненных по типным группам показателей индивидуальной надежности диагностики типа | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | 13 | 14 | 15 | 16 | 17 | 18 | 19 | 20 | 21 | 22 | 23 | |
| ИЛЭ | ЛИИ | СЭИ | ЭСЭ | СЛЭ | ЛСИ | ИЭИ | ЭИЭ | СЭЭ | ЭСИ | ИЛИ | ЛИЭ | ИЭЭ | ЭИИ | СЛИ | ЛСЭ | стандотклон показателя на выборке 5790 человек | стандотклон показателя в наборе 16-ти среднетипных значений | дисперсия показателя в наборе 16-ти среднетипных значений | Связь показателя с межтипными групповыми различиями = [18} / [17] | Линейн. коррел. c "голубым" A^6 | Линейн. коррел. c "голубым" N | Линейн. коррел. c "розо-вым" N | ||
| Расчет числа испытуемых и всех средних показателей по типным группам, выделенным на основе самотипирования (всего 5790 респондентов с заявленными типами) | N (число респондентоов с данным ТИМом) | 359 | 454 | 193 | 139 | 267 | 434 | 743 | 512 | 187 | 316 | 687 | 208 | 420 | 358 | 372 | 141 | 173,8 | 30189,7 | 0,35 | 0,88 | 1,00 | ||
| А | 0,869 | 0,876 | 0,862 | 0,847 | 0,900 | 0,894 | 0,884 | 0,872 | 0,888 | 0,865 | 0,863 | 0,848 | 0,886 | 0,887 | 0,856 | 0,867 | 0,107 | 0,015 | 0,00024 | 0,149 | 0,88 | 0,51 | 0,26 | |
| A^6 | 0,503 | 0,530 | 0,490 | 0,460 | 0,587 | 0,580 | 0,532 | 0,500 | 0,565 | 0,492 | 0,496 | 0,451 | 0,544 | 0,540 | 0,472 | 0,496 | 0,217 | 0,040 | 0,00156 | 0,188 | 0,88 | 0,43 | 0,19 | |
| f | 0,492 | 0,470 | 0,447 | 0,455 | 0,482 | 0,486 | 0,461 | 0,519 | 0,462 | 0,475 | 0,474 | 0,477 | 0,470 | 0,468 | 0,467 | 0,447 | 0,113 | 0,017 | 0,00030 | 0,158 | 0,26 | 0,38 | 0,37 | |
| Z | 1,136 | 1,113 | 1,023 | 1,010 | 1,197 | 1,198 | 1,096 | 1,192 | 1,133 | 1,086 | 1,089 | 1,050 | 1,127 | 1,120 | 1,049 | 1,028 | 0,353 | 0,059 | 0,00348 | 0,172 | 0,76 | 0,53 | 0,37 | |
| сходимость типных диагнозов по самотипированию и по анкете | 0,543 | 0,540 | 0,435 | 0,424 | 0,670 | 0,647 | 0,559 | 0,650 | 0,583 | 0,503 | 0,533 | 0,399 | 0,579 | 0,601 | 0,462 | 0,348 | 0,497 | 0,092 | 0,00843 | 0,191 | 0,71 | 0,70 | 0,47 | |
| Расчет числа испытуемых и всех средних показателей по типным группам, выделенным на основе типирования по опроснику (всего 5790 респондентов с заявленными типами) | N (число респондентоов с данным ТИМом) | 301 | 415 | 261 | 180 | 332 | 415 | 639 | 532 | 307 | 310 | 530 | 141 | 446 | 543 | 329 | 109 | 147,2 | 21681,4 | 0,46 | 1,00 | 0,88 | ||
| А | 0,863 | 0,899 | 0,837 | 0,820 | 0,888 | 0,903 | 0,882 | 0,868 | 0,881 | 0,853 | 0,867 | 0,845 | 0,897 | 0,881 | 0,862 | 0,863 | 0,107 | 0,022 | 0,00050 | 0,215 | 0,98 | 0,57 | 0,46 | |
| A^6 | 0,486 | 0,576 | 0,440 | 0,394 | 0,573 | 0,601 | 0,526 | 0,490 | 0,550 | 0,477 | 0,492 | 0,466 | 0,565 | 0,528 | 0,484 | 0,486 | 0,217 | 0,053 | 0,00285 | 0,254 | 1,00 | 0,46 | 0,35 | |
| f | 0,512 | 0,468 | 0,443 | 0,452 | 0,470 | 0,494 | 0,460 | 0,530 | 0,447 | 0,467 | 0,492 | 0,494 | 0,459 | 0,452 | 0,474 | 0,449 | 0,113 | 0,024 | 0,00060 | 0,222 | 0,05 | 0,23 | 0,40 | |
| Z | 1,162 | 1,156 | 0,964 | 0,939 | 1,156 | 1,239 | 1,088 | 1,207 | 1,083 | 1,055 | 1,126 | 1,102 | 1,125 | 1,072 | 1,077 | 1,024 | 0,353 | 0,077 | 0,00601 | 0,226 | 0,72 | 0,48 | 0,52 | |
| сходимость типных диагнозов по самотипированию и по анкете | 0,648 | 0,590 | 0,322 | 0,328 | 0,539 | 0,677 | 0,649 | 0,626 | 0,355 | 0,513 | 0,691 | 0,589 | 0,545 | 0,396 | 0,523 | 0,450 | 0,497 | 0,120 | 0,01448 | 0,250 | 0,41 | 0,47 | 0,74 | |
По результатам приведенной таблицы 11, два ее показателя наибольшим образом связаны с межтипными различиями (см. столбик 20, отражающий эту характеристику). Эти показатели – сходимость двух диагнозов (по анкете и по самотипированию) и шестая степень показателя А (где А - индивидуальная надежность типного профиля, вычисленная по Кронбаху).
Табл.12. Полная интеркорреляционная матрица показателей предыдущей таблицы 11, рассчитанная между наборами 16-ти среднетипных значений из предыдущей таблицы 11
| N | А | A^6 | f | Z | сход. | N | А | A^6 | f | Z | сход. | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| N | 1,000 | 0,261 | 0,192 | 0,373 | 0,370 | 0,470 | 0,881 | 0,464 | 0,346 | 0,400 | 0,516 | 0,744 |
| А | 0,261 | 1,000 | 0,980 | 0,200 | 0,786 | 0,803 | 0,510 | 0,857 | 0,877 | -0,095 | 0,538 | 0,174 |
| A^6 | 0,192 | 0,980 | 1,000 | 0,154 | 0,769 | 0,786 | 0,429 | 0,839 | 0,883 | -0,127 | 0,520 | 0,134 |
| f | 0,373 | 0,200 | 0,154 | 1,000 | 0,749 | 0,638 | 0,375 | 0,280 | 0,256 | 0,904 | 0,802 | 0,636 |
| Z | 0,370 | 0,786 | 0,769 | 0,749 | 1,000 | 0,939 | 0,530 | 0,743 | 0,757 | 0,499 | 0,867 | 0,501 |
| сходимость | 0,470 | 0,803 | 0,786 | 0,638 | 0,939 | 1,000 | 0,704 | 0,709 | 0,709 | 0,343 | 0,725 | 0,380 |
| N | 0,881 | 0,510 | 0,429 | 0,375 | 0,530 | 0,704 | 1,000 | 0,569 | 0,463 | 0,226 | 0,475 | 0,469 |
| А | 0,464 | 0,857 | 0,839 | 0,280 | 0,743 | 0,709 | 0,569 | 1,000 | 0,980 | 0,089 | 0,736 | 0,465 |
| A^6 | 0,346 | 0,877 | 0,883 | 0,256 | 0,757 | 0,709 | 0,463 | 0,980 | 1,000 | 0,048 | 0,722 | 0,408 |
| f | 0,400 | -0,095 | -0,127 | 0,904 | 0,499 | 0,343 | 0,226 | 0,089 | 0,048 | 1,000 | 0,726 | 0,753 |
| Z | 0,516 | 0,538 | 0,520 | 0,802 | 0,867 | 0,725 | 0,475 | 0,736 | 0,722 | 0,726 | 1,000 | 0,802 |
| сходимость | 0,744 | 0,174 | 0,134 | 0,636 | 0,501 | 0,380 | 0,469 | 0,465 | 0,408 | 0,753 | 0,802 | 1,000 |
Как видим, почти все показатели оказываются достаточно устойчивыми к способу выделения типных групп (по самотипированию или по анкете). Исключением является лишь сходимость, корреляция которой между двумя типными рядами, выделенными двумя разными способами, оказывается довольно умеренной (+0,380).
Важным фактом в таблицах является то, что все без исключения среднетипные показатели надежности (а также и валидности, если речь идет о сходимости) оказываются существенно положительно скоррелированными с объемом N соответствующих типных групп в выборке. Особенно сильны корреляции численности типных групп со средней в них сходимостью двух диагнозов (по анкете и по самотипированию). Дальше мы подробно разберем причины этого.
Сходимость диагнозов (по анкете и по самотипированию) для разных типных групп получилась существенно разной. Это не случайный результат. Различия средней сходимости диагнозов (по самотипированию и по результатам диагностических опросников) в разных типных группах респондентов получаются под действием трех основных причин: 1) Зависимости согласованности психологических самооценок от типа испытуемых (фактор зависимой от типа компетентности психологических самооценок); 2) От фактора социальной «модности» (или немодности) каждого из психотипов; 3) От размера типных групп (то есть частотности типа в выборке). Группы редких типов больше загрязнены посторонними ошибками, чем группы частых типов. Этот эффект (объяснение ему будет дано нами дальше) будем называть эффектом диффузии ошибок.
Теперь разберем все влияющие на сходимость факторы подробнее:
- Первый фактор - Разная компетентность психологической самооценки у представителей различных психотипов при отражении и понимании ими собственных психологических свойств в сравнении с другими людьми.
Будем называть этот фактор «фактором компетентности психологической самооценки». Этот фактор влияет на согласованность психологических самооценок человека и сказывается непосредственно и притом в первую очередь на высоте получающегося у человека по результатам опросника типного профиля, а также на связанных с этой высотой величинах (см. в таблице показатели А и А^6). Косвенно влияние фактора транслируется и на сходимость, поскольку ее величина тоже зависит от A^6. Фактор является, разумеется, индивидуальной характеристикой человека, но обнаруживает и существенные межтимные различия. Величина «голубого» A^6 в таблице (то есть средних значений этого показателя в каждой из 16-ти типных групп, собранных по итогам анкетной диагностики) наилучшим образом и непосредственно отражает среднюю величину этого фактора у каждого ТИМа. Для тех психотипов, где этот фактор выше, он незначительно повышает численность соответствующих типных групп (как при их формировании по итогам анкетной диагностики, так и по итогам самотипирования) – поскольку за счет более точной диагностики снижает отток истинных представителей соответствующего ТИМа из соответствующей ему типной группы, сформированной по результатам любой диагностики (как анкетной, так и по самотипированию). Заметим особо, что психологическая компетентность самооценок вряд ли тесно положительно связана с психологической компетентностью при оценке других людей. В данной работе мы оценки других людей со стороны субъекта не изучаем (хотя именно такая психологическая компетентность была бы полезна соционическим типировщикам, типодиагностам).
Этот второй фактор заключается в эффекте той или иной «социальной модности» психотипа. Степень модности (а значит, и социальной предпочтительности) зависит в основном от тех соционических стереотипов (положительных или негативных), которые на основе всевозможных размещенных в интернете описаний психотипов складываются в массовом сознании людей, знакомых с соционикой либо начинающих с ней знакомиться. Фактор социальной модности психотипов не влияет на индивидуальную надежность получающегося типного профиля (то есть на показатели A и A^6), он влияет только на среднегрупповую сходимость в выделенных по результатам самотипирования типных группах – снижая ее для «модных» типов, поскольку по его вине часть психотипов в этих группах оказывается определенной неверно (к модным типам любят причислять себя чужаки). К реальным ошибкам диагностики этот фактор ведет только при самотипировании, при анкетной диагностике он к диагностическим ошибкам не ведет. Но на сходимость внутри типных групп, образованных по результатам анкетной диагностики, он косвенно все равно тоже влияет (так как сходимость есть доля совпадений двух диагнозов, один из которых самотипировочный).
«Модные» психотипы притягивают к себе ошибочные самотипирования со стороны представителей близких, смежных типов. По этой причине показатель сходимости в группах «модных» типов, если эти типы определены по результатам самотипирования, снижается, а численность этих групп растет (в силу своей «модности» тип избыточно размывается представителями других типов, то есть в нем получается выше процент «ложных тревог»). Короче говоря, если типная группа какого-то «модного» типа сформирована на основе самотипирования, то процент ошибок в ней будет выше (за счет притягивания к модному типу при самотипировочной диагностике многих представителей «не своих» типов. И напротив, если типная группа представителей этого же «модного типа» сформирована на основе анкетных диагнозов, то средняя в этой группе надежность анкетных диагнозов не меняется, а средняя по группе надежность самотипировочных диагнозов как раз растет, а не падает (снижается процент ошибок) – потому что в этом случае посторонние типы в группу уже заведомо не привлекаются, но зато «свои типы» из нее по результатам самотипирования не теряются (истинные представители «модного типа» по результатам самотипирования реже уходят в «чужой» тип, социальной «модной» нужды для этого у них нет). Таким образом, в случае формирования типных групп по анкете влияние фактора на сходимость в типной группе «модного типа» становится уже не отрицательным, а положительным. Еще раз и чуть по-другому сформулируем объяснение, почему это происходит. Если группа какого-то «модного» типа образована по результатам чисто анкетной диагностики, то избыточно привлеченных в эту группу за счет «модности» этого типа чужаков совсем не будет, а вот свой истинный диагноз по итогам самотипирования получит более высокая доля истинных представителей этого типа (так как для истинных представителей «модного типа» в ходе самотипирования в «модный тип» нет нужды нарочно «убегать» от своего истинного типного диагноза).
В результате этих двух разнонаправленных механизмов этот фактор в ряду 16-ти типов должен быть отрицательно скоррелирован с их среднетипной сходимостью, если типные группы сформированы по итогам самотипирования, и должен быть положительно скоррелирован со среднетипной сходимостью, если типные группы сформированы по итогам анкетной диагностики. На численность типных групп «модных типов», сформированных по итогам самотипирования, фактор влияет положительно (фиктивно увеличивая их численность), а на численность групп, сформированных по итогам анкетной диагностики, вообще никак не влияет. На индивидуальные показатели надежности типного профиля (его высоту S и связанные с ней показатели надежности А и А^6, а также на среднегрупповые значения этих показателей) фактор тоже никак не влияет.
Для количественной оценки социальной модности-немодности психотипа достаточно сосчитать отношение численности соответствующей типной группы по данным самотипирования к численности этой же типной группы в выборке по данным анкетной диагностики (поскольку в этом последнем случае численность типных групп свободна от влияния фактора модности типов). Правда, перед эти лучше очистить численность соответствующих типных групп от влияния на них предыдущего фактора - фактора разной компетентности психологических самооценок у представителей разных типов. В тех типных группах, где эта психологическая компетентность выше, фактор психологической компетентности повышает численность соответствующих групп (так как снижает отток из этих групп истинных представителей этого типа). Вот это влияние на численность групп и должно быть предварительно устранено, если нам нужно рассчитать для каждого психотипа (по отношению численности соответствующих типных групп) величину второго фактора, фактора социальной модности типа.
В следующей таблице 13 представлены результаты этих операций:
Табл.13
| ИЛЭ | ЛИИ | СЭИ | ЭСЭ | СЛЭ | ЛСИ | ИЭИ | ЭИЭ | СЭЭ | ЭСИ | ИЛИ | ЛИЭ | ИЭЭ | ЭИИ | СЛИ | ЛСЭ | ||||||
| 1 | до коррекции на устранение корреляции с A^6 | самотипирование | N (число респондентоов с данным ТИМом) | 359 | 454 | 193 | 139 | 267 | 434 | 743 | 512 | 187 | 316 | 687 | 208 | 420 | 358 | 372 | 141 | ||
| 2 | до коррекции на устранение корреляции с A^6 | анкетный диагноз | N (число респондентоов с данным ТИМом) | 301 | 415 | 261 | 180 | 332 | 415 | 639 | 532 | 307 | 310 | 530 | 141 | 446 | 543 | 329 | 109 | ||
| 3 | до коррекции на устранение корреляции с A^6 | анкетный диагноз | A^6 | 0,486 | 0,576 | 0,440 | 0,394 | 0,573 | 0,601 | 0,526 | 0,490 | 0,550 | 0,477 | 0,492 | 0,466 | 0,565 | 0,528 | 0,484 | 0,486 | ||
| 4 | Фактор компетентности психологических самооценок в зависимости от ТИМа (значения строки 3, нормированные к нулевому среднему и единичному станд. отклонению) | -0,42 | 1,26 | -1,28 | -2,15 | 1,20 | 1,74 | 0,33 | -0,34 | 0,77 | -0,58 | -0,30 | -0,80 | 1,06 | 0,36 | -0,45 | -0,41 | ||||
| 5 | после коррекции на устранение корреляции с фактором психологической компетентности (строка 4) | самотипирование | N (число респондентоов с данным ТИМом) | 384,4 | 377,3 | 270,9 | 269,6 | 193,8 | 328,2 | 722,8 | 532,5 | 140,1 | 351,3 | 705,3 | 256,7 | 355,8 | 336 | 399,3 | 166,1 | ||
| 6 | после коррекции на устранение корреляции с фактором психологической компетентности (строка 4) | анкетный диагноз | N (число респондентоов с данным ТИМом) | 329,2 | 329,5 | 347,8 | 325,5 | 250,5 | 297,1 | 616,5 | 554,8 | 254,7 | 349,3 | 550,4 | 195,2 | 374,5 | 518,5 | 359,4 | 136,9 | ||
| 7 | Окончательный показатель "социальной модности" психотипа (элемент в строке 5, деленный на элемент в строке 6) | 1,17 | 1,14 | 0,78 | 0,83 | 0,77 | 1,10 | 1,17 | 0,96 | 0,55 | 1,01 | 1,28 | 1,31 | 0,95 | 0,65 | 1,11 | 1,21 | ||||
| 8 | Нормированная величина фактора "социальной модности" (приведение строки 7 к нулевому среднему и единичному стандартному отклонению) | 0,75 | 0,65 | -1,00 | -0,78 | -1,02 | 0,47 | 0,78 | -0,18 | -2,03 | 0,02 | 1,27 | 1,42 | -0,23 | -1,59 | 0,50 | 0,96 | ||||
| 9 | после окончательной коррекции на устранение корреляции еще и с фактором социальной модности (строка 8) | самотипирование | N (число респондентоов с данным ТИМом) | 327,4 | 328,0 | 346,2 | 328,1 | 270,9 | 292,7 | 664,2 | 546,2 | 293,4 | 349,4 | 609,6 | 149,6 | 372,9 | 455,9 | 361,6 | 93,7 | ||
Из приведенной таблицы видим, что фактор компетентности психологических самооценок (строка 4 таблицы) наиболее высок (в порядке убывания) у представителей типов ЛСИ, ЛИИ, СЛЭ, ИЭЭ, СЭЭ. Самые же низкие значения он имеет у альфийских этиков ЭСЭ и СЭИ.
Фактор «социальной модности» психотипов наиболее высок у черных логиков и интуитов. В порядке убывания повышенную популярность имеют: ЛИЭ, ИЛИ, ЛСЭ, ИЭИ, ИЛЭ, ЛИИ. Наибольшую негативную популярность обнаруживают СЭЭ, ЭИИ, СЛЭ, СЭИ, ЭСЭ.
В последней строке таблицы представлена численность типных групп, образованных по результатам самотипирования, после внесения в нее коррекций на оба фактора: как психологической компетентности, так и социальной модности. До внесения каких бы то ни было коррекций на эти факторы численности типных групп, образованных по итогам самотипирования и анкетной диагностики, коррелировали между собой в ряду 16-ти психотипов на уровне 0,88. После внесения в них коррекции на фактор средней психологической компетентности разных ТИМов корреляция осталась на уровне 0,87. Но после внесения в численность типных групп, образованных по итогам самотипирования, последней коррекции на фактор социальной модности, корреляция между двумя рядами численности типных групп выросла до 0,98.
Ниже мы приводим еще одну таблицу 14 – с линейными корреляциями, которые в рядах 16-ти среднетипных данных обнаруживают различные показатели средней надежности и средней сходимости в типных группах, во-первых, с окончательно скорректированной численностью соответствующих типных групп, и во-вторых, со значениями (для каждого ТИМа) фактора компетентности психологических самооценок и фактора социальной модности ТИМов:
Табл.14.
| корреляция со скорректированной на фактор компетентности частотой ТИМов по анкете MOLTI | корреляция со скорректированной на факторы компетентности и модности частотой ТИМов по итогам самотипирования | корреляция с фактором компетентности психологических самооценок | корреляция с фактором модности ТИМа | ||
|---|---|---|---|---|---|
| Ряд 16-ти среднетипных значений показателя, где типные группы сформированы по анкеты MOLTI. Без коррекций. | N (число респондентоов с данным ТИМом по итогам анкетной диагностики - MOLTI) | 0,89 | 0,88 | 0,46 | -0,04 |
| Ряд 16-ти среднетипных значений показателя, где типные группы сформированы по анкеты MOLTI. Без коррекций. | А | 0,14 | 0,16 | 0,98 | -0,01 |
| Ряд 16-ти среднетипных значений показателя, где типные группы сформированы по анкеты MOLTI. Без коррекций. | A^6 (нормированные значения этого показателя образуют фактор компетентности психологически самооценок) | 0,00 | 0,03 | 1,00 | -0,08 |
| Ряд 16-ти среднетипных значений показателя, где типные группы сформированы по анкеты MOLTI. Без коррекций. | f | 0,23 | 0,21 | 0,05 | 0,48 |
| Ряд 16-ти среднетипных значений показателя, где типные группы сформированы по анкеты MOLTI. Без коррекций. | сходимость типных диагнозов по самотипированию и по анкете | 0,32 | 0,34 | 0,41 | 0,73 |
| Ряд 16-ти среднетипных значений показателя, где типные группы сформированы по итогам самотипирования. Без коррекций. | N (число респондентоов с данным ТИМом по итогам самотипирования) | 0,81 | 0,84 | 0,35 | 0,41 |
| Ряд 16-ти среднетипных значений показателя, где типные группы сформированы по итогам самотипирования. Без коррекций. | А | 0,12 | 0,15 | 0,88 | -0,39 |
| Ряд 16-ти среднетипных значений показателя, где типные группы сформированы по итогам самотипирования. Без коррекций. | A^6 | 0,03 | 0,08 | 0,88 | -0,41 |
| Ряд 16-ти среднетипных значений показателя, где типные группы сформированы по итогам самотипирования. Без коррекций. | f | 0,28 | 0,26 | 0,25 | 0,15 |
| Ряд 16-ти среднетипных значений показателя, где типные группы сформированы по итогам самотипирования. Без коррекций. | сходимость типных диагнозов по самотипированию и по анкете | 0,43 | 0,45 | 0,71 | -0,35 |
| Ряд 16-ти среднетипных значений показателя, где типные группы сформированы по анкеты MOLTI. После коррекции на фактор психологической компетентности. | N - частота ТИМов после коррекции на фактор психологической компетентности | 1,00 | 0,98 | 0,00 | 0,00 |
| Ряд 16-ти среднетипных значений показателя, где типные группы сформированы по итогам самотипирования. После коррекции на факторы психологической компетентности и социальной модности | N - частота ТИМов после коррекции на факторы психологической компетентности и социальной модности | 0,98 | 1,00 | 0,03 | 0,00 |
| фактор модности ТИМов | 0,00 | 0,00 | -0,07 | 1,00 |
Желтым цветом в таблице выделены корреляции, особенно важные для текущего обсуждения. Во-первых, мы видим (как выше и предсказывалось), что фактор модности ТИМа коррелирует положительно (+0,73) со сходимостью в разных тимных группах, если они выделялись на основе анкетных диагнозов, и коррелирует с аналогичной сходимостью в разных тимных группах отрицательно (-0,35), если группы формировались на основе самотипирования. Во-вторых, корреляция средней по типным группам сходимости с частотой ТИМов (то есть численностью соответствующих типных групп) больше для случая, когда группы формируются по итогам самотипирования (+0,45), чем когда они формируются поитогам анкетной диагностики (+0,32). Этот результат связан с тем, что вероятность правильного определения типа при самотипировании меньше, чем при анкетной диагностике, и вследствие этого вызывающий эту корреляцию эффект диффузии ошибок, о котором подробней пойдет речь в следующем абзаце, оказывается больше в случае самотипирования.
Суть этого эффекта состоит во взаимной диффузии ошибок ложного узнавания (ложных тревог) со стороны смежных по свойствам типов. Этот эффект не симметричен для типов объективно более редких и более частых в обследуемой субпопуляции. Он гораздо сильнее проявляется для редко встречающихся в субпопуляции психотипов. А именно, внутри типных групп объективно редких типов средние показатели сходимости падают, потому что эти типные группы внутри себя размываются ошибочными отнесениями людей к этому типу гораздо чаще (в большем проценте случаев), чем это происходит для объективно частых в субпопуляции типов. Почему так? Поясним на примере условной обследуемой субпопуляции, состоящей для простоты рассмотрения только из представителей двух типов: ЛИЭ и ЛИИ. Причем представителей ЛИИ в популяции пусть объективно в 4 раза больше, чем представителей ЛИЭ (400 человек ЛИИ + 100 человек ЛИЭ). То есть ЛИИ для этой субпопуляции – частый тип, ЛИЭ – редкий. Если мы знаем, что выборка состоит только из этих двух типов, и последующая диагностика типов в этой выборке осуществляется со 100% надежностью, то все типы определяются абсолютно точно, и ни для одного из них ошибок не возникает. Если диагностика осуществляется с 90% надежностью, то 90% всех ЛИИ (360 человек) и 90% всех ЛИЭ (90 человек) будут правильно отнесены к своему типу, но 10% ЛИИ (40 человек) будут ошибочно зачислены в ЛИЭ, точно так же 10% подлинных ЛИЭ (10 человек) будут ошибочно зачислены в ЛИИ. В итоге в группе диагностированных ЛИИ мы будем иметь всего 370 человек (меньше, чем подлинные 400), причем среди них будут 360 настоящих ЛИИ (97,3%) и 10 человек (2,7%) представителей «чужих» типов. А в группе ЛИЭ, изначально более редкой, по итогам диагностики окажется 130 человек (больше, чем должно), причем только 90 человек (69,2%) подлинных ЛИЭ, и 40 человек (30,8%) представителей «чужого» типа. Асимметрия ситуации еще более обостряется, если надежность диагностики дополнительно снизится. Пусть она составляет теперь 70%. В этом случае 280 ЛИИ и 70 ЛИЭ будут правильно отнесены к своему типу, ошибочно в ЛИЭ будут зачислены 120 человек и ошибочно в ЛИИ – 30 человек. Итого мы будем иметь 310 диагностированных ЛИИ, из которых верно диагностированными будут 280 человек (90,3%) и ошибочно диагностированными 30 человек (9,7%). Намного хуже ситуация получится для изначально редкого типа ЛИЭ. Всего в ЛИЭ будет продиагностировано 190 человек, из них только 70 правильно (36,8%) и намного больше ошибочно – 120 человек (63,2%).
Это и есть эффект несимметричной диффузии ошибок. Он приводит к появлению устойчивых положительных корреляций между средней сходимостью в каждой выделенной по результатам не вполне идеальной диагностики типной группе и численностью этой типной группы. У объективно частых типов фактор диффузии ошибок незначительно снижает их диагностированную численность и мало влияет на надежность их определения, но у объективно редких типов он фиктивно (и значительно в процентном отношении) завышает численность соответствующей типной группы и резко снижает показатели надежности диагностики внутри этой группы, поскольку сильно размывает ее представителями «чужих» типов. Эффект диффузии ошибок проявляется и при самотипировании, и при анкетной диагностике. Но он всегда сильнее выражен для тех случаев, где надежность диагностики изначально была ниже. Например, если надежность самотипирования ниже, чем надежность анкетной диагностики, то для самотипирования эффект диффузии ошибок будет выражен сильнее, и, в частности, для групп «редких» типов (и только для них), образованных по результатам самотипирования, показатели средней сходимости диагнозов внутри этих групп получатся достоверно и намного ниже, чем внутри одноименных типных групп, образованных по итогам более надежной диагностической процедуры.
К сожалению, провести обратную коррекцию, то есть скорректировать эмпирически выявленную численность типных групп с опорой на их положительную корреляцию со средней в этих группах сходимостью, прямым способом нельзя (в данном случае положительная корреляция эмпирически выявленной частоты ТИМа со сходимостью внутри типных групп указывает не на завышение, а как раз на занижение численности частоты ТИМов и завышение численности редких – поэтому попытка скорректировать численность групп, устранив корреляцию со сходимостями, приведет лишь к обратному результату, еще больше увеличив ошибку в определении истинной численности типов. На самом деле вполне можно построить математическую модель для реальной коррекции частотности типов - с выходом, в конечном счете, на частоту реальной представленности подлинных ТИМов в субпопуляции. Но в данной статье мы это делать не будем, чтобы не загромождать ее дополнительными выкладками. Нам пока достаточно уточненной численности типов, скорректированной на паразитное влияние двух факторов (психологической компетентности и социальной модности) и затем средневзвешенной по независимым данным самотипирования и анкетной диагностики с весами соответственно 0,63 и 0,83 (эти веса получены в последующем разделе статьи: «Расчет и сравнение средней вероятности определения истинного типа в случае самотипирования и в случае анкетной диагностики по MOLTI», ори отражают среюнюю надежность типодиагностики по самотипированию и по анкете MOLTI). Окончательные результаты численности психотипов в интернет-выборке респондентов MOLTI, из которых устранено паразитное зашумляющее влияние факторов разной психологической компетентности и разной социальной модности ТИМов, а также полученные из этих скорректированных показателей численности нормированные значения фактора диффузии ошибок, представлены в следующей таблице 15:
Табл.15.
| ИЛЭ | ЛИИ | СЭИ | ЭСЭ | СЛЭ | ЛСИ | ИЭИ | ЭИЭ | СЭЭ | ЭСИ | ИЛИ | ЛИЭ | ИЭЭ | ЭИИ | СЛИ | ЛСЭ | |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Абс. Численность ТИМов в выборке (с коррекцией на факторы психологической компетентности и социальной модности ТИМов) | 328,4 | 328,9 | 347,1 | 326,6 | 259,3 | 295,2 | 637,1 | 551,1 | 271,4 | 349,3 | 575,9 | 175,5 | 373,8 | 491,5 | 360,3 | 118,3 |
| Соответствующая численность ТИМов в долях от выборки | 0,057 | 0,057 | 0,060 | 0,056 | 0,045 | 0,051 | 0,110 | 0,095 | 0,047 | 0,060 | 0,099 | 0,030 | 0,065 | 0,085 | 0,062 | 0,020 |
| Нормированные (к среднему нулю и единичному стандартному отклонению) значения численности - нормированные значения фактора диффузии ошибок | -0,25 | -0,24 | -0,11 | -0,26 | -0,75 | -0,49 | 2,03 | 1,39 | -0,67 | -0,09 | 1,58 | -1,37 | 0,09 | 0,95 | -0,01 | -1,79 |
Как видим, самый редкий в интернет-выборке тип – ЛСЭ (не более 2%), самый частый – его конфликтер ИЭИ (не менее 11%)..
- Четвертый и последний фактор, влияющий на среднетипные различия в сходимости диагнозов – фактор среднего расстояния от местоположения ТИМа в многомерном психологическом пространстве до местоположения других ТИМов (фактор средней удаленности ТИМа от других 15-ти ТИМов)
Влияние диффузии ошибок на среднегрупповые показатели сходимости можно устранить, если скорректировать все средние для типных групп показатели сходимости на их корреляцию с получающейся численностью соответствующих типных групп. Можно устранить из среднетипных значений сходимости и их корреляцию с факторами разной психологической компетентности и модности ТИМов. Тогда для скорректированных сходимостей (из которых полностью устранены влияния всех трех факторов - компетентности, модности и диффузии ошибок) получаем следующую таблицу 16, где эти сходимости выделены в первые два ее столбика, а прочие столбики занимают усредненные по типным группам значения функции f (как без коррекции на три уже известных нам влияющих на сходимость фактора, так и с коррекцией на них). Оказывается, что усредненные по типным группам и скорректированные на малые корреляции с тремя предыдущими факторами значения этой функции f и являются последним искомым 4-м фактором, влияющим на сходимость. Пятого фактора быть уже не может, поскольку после 4-го фактора дисперсия различий сходимости между 16-ю типными группами практически исчерпывается.
Напомним также, что функция f (как раз отражающая фактор средней удаленности ТИМа от других 15-ти ТИМов) введена в 8-м разделе статьи.
Табл.16.
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | |
|---|---|---|---|---|---|---|---|---|
| Сходимость типных диагнозов (по самотипированию и по анкете). Среднетипные значения в типных группах, выделенных на основе анкетных диагнозов. Значения скорректированы на факторы компетентности, модности и диффузии ошибок. | Сходимость типных диагнозов (по самотипированию и по анкете). Среднетипные значения в типных группах, выделенных на основе самотипирования. Значения скорректированы на факторы компетентности, модности и диффузии ошибок. | Усредненная по типным группам, выделенным на основе анкеты, функция f (функция f описана в разделах статьи выше, характеризует величину превосходства главного пика профиля над вторым и третьим по высоте пиками). Чем больше f, тем точнее диагностика- меньше конкуренция главному пику-претенденту на ТИМ со стороны вторичных пиков. Напомним, что f=(h1-0,425*h2-0,353*h3)/h1, где h1, h2, h3 – соответственно высоты 1-го (главного), 2-го и 3-го пиков диагностированного типного профиля. | Усредненная по типным группам, выделенным на основе самотипирования, функция f (функция f описана в разделах статьи выше, характеризует величину превосходства главного пика профиля над вторым и третьим по высоте пиками). Чем больше f, тем точнее диагностика- меньше конкуренция главному пику-претенденту на ТИМ со стороны вторичных пиков. Напомним, что f=(h1-0,425*h2-0,353*h3)/h1, где h1, h2, h3 – соответственно высоты 1-го (главного), 2-го и 3-го пиков диагностированного типного профиля. | Усредненная по типным группам, выделенным на основе анкеты, функция f - с коррекцией (с исключенным влиянием трех факторов - компетентности, модности и диффузии ошибок) | Усредненная по типным группам, выделенным на основе самотипирования, функция f - с коррекцией (с исключенным влиянием трех факторов - компетентности, модности и диффузии ошибок) | Усредненная по двум способам выделения типных групп функция f. (Усреднение показателей в столбиках 5 и 6) | Искомый Фактор №4 - нормированные значения столбика 7. | |
| ИЛЭ | 0,612 | 0,604 | 0,512 | 0,492 | 0,505 | 0,493 | 0,499 | 1,480 |
| ЛИИ | 0,481 | 0,488 | 0,468 | 0,470 | 0,460 | 0,464 | 0,462 | -0,561 |
| СЭИ | 0,476 | 0,490 | 0,443 | 0,447 | 0,457 | 0,456 | 0,456 | -0,896 |
| ЭСЭ | 0,512 | 0,548 | 0,452 | 0,455 | 0,465 | 0,467 | 0,466 | -0,338 |
| СЛЭ | 0,602 | 0,583 | 0,470 | 0,482 | 0,485 | 0,483 | 0,484 | 0,637 |
| ЛСИ | 0,570 | 0,568 | 0,494 | 0,486 | 0,489 | 0,480 | 0,484 | 0,670 |
| ИЭИ | 0,490 | 0,481 | 0,460 | 0,461 | 0,440 | 0,447 | 0,444 | -1,594 |
| ЭИЭ | 0,602 | 0,617 | 0,530 | 0,519 | 0,524 | 0,515 | 0,519 | 2,608 |
| СЭЭ | 0,526 | 0,486 | 0,447 | 0,462 | 0,474 | 0,466 | 0,470 | -0,117 |
| ЭСИ | 0,543 | 0,545 | 0,467 | 0,475 | 0,468 | 0,478 | 0,473 | 0,032 |
| ИЛИ | 0,539 | 0,527 | 0,492 | 0,474 | 0,470 | 0,464 | 0,467 | -0,317 |
| ЛИЭ | 0,553 | 0,554 | 0,494 | 0,477 | 0,486 | 0,484 | 0,485 | 0,686 |
| ИЭЭ | 0,510 | 0,500 | 0,459 | 0,470 | 0,460 | 0,466 | 0,463 | -0,529 |
| ЭИИ | 0,472 | 0,501 | 0,452 | 0,468 | 0,463 | 0,467 | 0,465 | -0,386 |
| СЛИ | 0,502 | 0,507 | 0,474 | 0,467 | 0,469 | 0,468 | 0,468 | -0,227 |
| ЛСЭ | 0,452 | 0,478 | 0,449 | 0,447 | 0,448 | 0,455 | 0,452 | -1,147 |
| корреляция 1-го столбика с прочими | 1 | 0,922 | 0,781 | 0,831 | 0,874 | 0,840 | 0,867 | 0,867 |
| корреляция 2-го столбика с прочими | 0,922 | 1 | 0,810 | 0,834 | 0,897 | 0,908 | 0,910 | 0,910 |
В заключение разбора всех четырех факторов, влияющих на различия между 16-ю среднетипными показателями сходимости, приведем таблицы 17 и 18 с характеристиками и с полным соционическим разложением (по типам, признакам и функциям) для всех четырех нормированных факторов, влияющих на сходимость:
Табл.17.
| фактор сцепленной с ТИМом компетентности психологических самооценок | фактор социальной модности типа | фактор диффузии ошибок (сцеплен не с ТИМом, а с его долей в выборке - в данном случае рассчитан для интернет-выборки респондентов анкет MOLTI) | Фактор превышения первой гармоники над второй и третьей в среднем типном профиле представителей ТИМа. Объективно сцеплен с ТИМом, с его местоположением в психологическом пространстве, с расстоянием в этом пространстве от ближайших соседних ТИМов (потенциальных конкурентов при диагностике) | |
|---|---|---|---|---|
| Комментарии к фактору | Неизбежные при диагностике ошибки отнесения не к своему, а к чужому ТИМу, в выборке распределяются неравномерно - их относительная доля выше в группах редких в выборке типов и ниже - в группах частых типов. В этом суть фактора. Он сцеплен не с ТИМом, а с его долей в выборке, то есть с ситуативной численностью ТИМа в какой-то выборке. Для разных по частотному составу ТИМов выборок и закрепленные за ТИМами значения фактора получаются тоже разными. | Фактор измеряется как нормированное, а до того усредненное по типной группе испытуемых значение величины f, из которой исключено влияние трех предыдущих факторов (что меняет ее очень незначительно, поскольку корреляции f с этими факторами минимальны). Напомним, что f=(h1-0,425*h2-0,353*h3)/h1, где h1, h2, h3 – соответственно высоты 1-го (главного), 2-го и 3-го пиков диагностированного типного профиля. Чем f больше, тем больше в типной группе испытуемых средняя дистанция между самым высоким пиком профиля и двумя следующими по высоте пиками, а значит, и тем реже случаются диагностические ошибки. С точки зрения иной метафоры, местоположения ТИМа в многомерном психологическом пространстве, высокое значение фактора соответствует ТИМам, которые в этом пространстве находятся далеко от соседей-ТИМов, занимая наиболее изолированное положение. | ||
| Эффекты фактора в типных группах, образованных по итогам самотипирования | Фактор повышает точность диагностики по самотипированию. Высокие значения фактора увеличивают среднетипную сходимость и более умеренно увеличивают численность этой типной группы (препятствуя оттоку из нее истинных представителей ТИМа) | Фактор влияет на результаты диагноза по самотипированию. Высокие значения фактора уменьшают среднетипную сходимость (за счет притока в типную группу фиктивных представителей) и увеличивают численность этой типной группы (за счет притока в нее фиктивных представителей) | Высокие значения фактора способствуют повышению среднетипной сходимости (за счет повышенного оттока из типной группы случаев ошибочных диагнозов в другие типные группы, где значение этого фактора меньше среднего - там средняя сходимость за счет этого падает) | Высокие значения фактора соответствуют малым конкурирующим помехам со стороны других ТИМов при диагностике (удаленность ТИМа по своим свойствам от всех прочих соседей). Поэтому высокие значения фактора снижают вероятность диагностических ошибок и тем самым повышают сходимость. |
| Эффекты фактора в типных группах, образованных по итогам анкетной диагностики MOLTI | Фактор повышает точность диагностики по анкете. Высокие значения фактора увеличивают среднетипную сходимость и увеличивают численность этой типной группы (препятствуя оттоку из нее истинных представителей ТИМа) | Высокие значения фактора значительно увеличивают среднетипную сходимость (исключительно за счет того, что истинные представители ТИМа также и по результатам своего самотипирования почти все, без потерь численности, получают верный “модный” диагноз, совпадающий в данном случае с анкетным). На численность же типной группы, выделяемой по результату анкетного диагноза, фактор никак не влияет (так как не влияет на сам анкетный диагноз). | Высокие значения фактора способствуют повышению среднетипной сходимости (за счет повышенного оттока из типной группы случаев ошибочных диагнозов в другие типные группы, где значение этого фактора меньше среднего - там средняя сходимость за счет этого падает) | Высокие значения фактора соответствуют малым конкурирующим помехам со стороны других ТИМов при диагностике (удаленность ТИМа по своим свойствам от всех прочих соседей). Поэтому высокие значения фактора снижают вероятность диагностических ошибок и тем самым повышают сходимость. |
| связанная с фактором доля дисперсии разброса показателя сходимости в 16 типных группах, образованных по итогам самотипирования (в скобках - корреляция сходимости со значениями фактора в типных группах, образованных по самотипированию) | 0,495 (0,708) | 0,122 (—0,351) | 0,191 (0,439) | 0,188 (0,437) |
| связанная с фактором доля дисперсии разброса показателя сходимости в 16 типных группах, образованных по итогам анкетной диагностики MOLTI (в скобках - корреляция сходимости со значениями фактора в типных группах, образованных по итогам анкетного диагноза) | 0,166 (0,408) | 0,529 (0,727) | 0,109 (0,330) | 0,135 (0,367) |
Табл.18. Весовые нагрузки четырех факторов, влияющих на среднетипные показатели сходимости, в проекции на типы, функции и полюса признаков:
| фактор сцепленной с ТИМом компетентности психологических самооценок | фактор социальной модности типа | фактор диффузии ошибок (сцеплен не с ТИМом, а с его долей в выборке - в данном случае рассчитан для интернет-выборки респондентов анкет MOLTI) | Фактор превышения первой гармоники над второй и третьей в среднем типном профиле представителей ТИМа. Объективно сцеплен с ТИМом, с его местоположением в психологическом пространстве, с расстоянием в этом пространстве от ближайших соседних ТИМов (потенциальных конкурентов при диагностике) | |
|---|---|---|---|---|
| ИЛЭ | -0,42 | 0,75 | -0,25 | 1,48 |
| ЛИИ | 1,26 | 0,65 | -0,24 | -0,56 |
| СЭИ | -1,28 | -1,00 | -0,11 | -0,90 |
| ЭСЭ | -2,15 | -0,78 | -0,26 | -0,34 |
| СЛЭ | 1,20 | -1,02 | -0,75 | 0,64 |
| ЛСИ | 1,74 | 0,47 | -0,49 | 0,67 |
| ИЭИ | 0,33 | 0,78 | 2,03 | -1,59 |
| ЭИЭ | -0,34 | -0,18 | 1,39 | 2,61 |
| СЭЭ | 0,77 | -2,03 | -0,67 | -0,12 |
| ЭСИ | -0,58 | 0,02 | -0,09 | 0,03 |
| ИЛИ | -0,30 | 1,27 | 1,58 | -0,32 |
| ЛИЭ | -0,80 | 1,42 | -1,37 | 0,69 |
| ИЭЭ | 1,06 | -0,23 | 0,09 | -0,53 |
| ЭИИ | 0,36 | -1,59 | 0,95 | -0,39 |
| СЛИ | -0,45 | 0,50 | -0,01 | -0,23 |
| ЛСЭ | -0,41 | 0,96 | -1,79 | -1,15 |
| ЭКСТРАВЕРТ | -0,136 | -0,138 | -0,451 | 0,410 |
| ИРРАЦИОНАЛ | 0,114 | -0,122 | 0,238 | -0,195 |
| СТАТИК | 0,674 | -0,372 | -0,181 | 0,153 |
| ИНТУИТ | 0,144 | 0,359 | 0,522 | 0,173 |
| РАССУДИТЕЛЬНЫЙ | -0,253 | -0,092 | -0,202 | -0,325 |
| ТАКТИК | -0,091 | 0,406 | 0,101 | -0,218 |
| БЕСПЕЧНЫЙ | -0,133 | 0,219 | -0,105 | 0,478 |
| ЛОГИК | 0,228 | 0,626 | -0,417 | 0,153 |
| ВЕСЕЛЫЙ | 0,043 | -0,041 | 0,164 | 0,251 |
| КОНСТРУКТИВИСТ | -0,334 | -0,128 | 0,320 | 0,436 |
| УСТУПЧИВЫЙ | -0,199 | 0,041 | -0,173 | -0,149 |
| КВЕСТИМ | 0,021 | 0,182 | 0,046 | 0,059 |
| ДЕМОКРАТ | -0,437 | 0,038 | -0,176 | -0,004 |
| ПОЗИТИВИСТ | -0,077 | -0,059 | -0,008 | 0,022 |
| ПРОЦЕССОР | 0,016 | -0,168 | 0,077 | 0,237 |
| БИ | 0,83 | 1,68 | 3,16 | 0,64 |
| ЧИ | 0,38 | 0,11 | 0,68 | -0,19 |
| БС | -1,56 | -1,03 | -1,18 | -2,35 |
| ЧС | 1,04 | -1,50 | -1,23 | 0,73 |
| БЛ | 1,54 | 1,61 | -0,67 | 1,10 |
| ЧЛ | -0,34 | 2,32 | -2,19 | 0,11 |
| БЭ | -0,09 | -1,90 | 0,85 | -1,32 |
| ЧЭ | -1,45 | -1,67 | 1,30 | 0,70 |
| БК | -0,52 | 0,52 | -0,30 | 0,06 |
| ЧК | 0,48 | 0,76 | 0,22 | 0,59 |
| БД | 1,97 | -0,80 | 0,48 | -0,28 |
| ЧД | -2,27 | -0,11 | -1,12 | 0,21 |
ЧЭ и БС, как видим из таблицы, и не «компетентны», и не «модны», а БЛ и БИ – наоборот.
- Расчет и сравнение средних вероятностей определения истинного типа в случае самотипирования и в случае анкетной диагностики по MOLTI
Сходимость двух типных диагнозов – это (приблизительно, то есть в пренебрежении членом, отражающим возможность случайного совпадения диагнозов) есть произведение вероятности получить истинный тип по первой диагностической процедуре (P1) на вероятность получить этот же истинный тип по второй независимой диагностической процедуре (P2). Первая процедура – самотипирование испытуемых. Вторая – типирование по анкете MOLTI. С большой степенью точности средняя сходимость на выборке тоже равна произведению средней P1 на среднюю P2. Средние между всеми типными группами значения вероятности истинного диагноза P будем обозначать как Р1средн и Р2средн (соответственно для самотипирования и для анкетных диагнозов). Итак, мы имеем два ряда усредненных по типным группам показателей сходимости. Один ряд – это 16 среднетипных значений сходимости, где типы испытуемых собирались в группы по итогам их самотипирования. Другой ряд состоит из аналогичных 16 показателей сходимости, тоже усредненных в каждой типной группе, где группы собирались на основе анкетных диагнозов MOLTI. В каждом ряду среднетипные показатели сходимости для разных типов разные, и их разброс между типными группами характеризуется величиной стандартного отклонения S (S1 для ряда 16-ти типных групп, сформированных по самотипированию, и S2 – для ряда 16-ти типных групп, сформированных по анкетным диагнозам). Средняя по всем типным группам сходимость для обоих рядов данных одинакова и равна 0,529. S1=0,0918; S2=0,1203.
Можно математически показать (на этом не останавливаемся, расчеты достаточно тривиальны), что Р1средн/Р2средн=S1/S2. С другой стороны, Средняя Сходимость= Р1средн * Р2средн. Имеем таким образом простейшую решаемую систему двух уравнений с двумя неизвестными (Р1средн и Р2средн). Средняя сходимость известна и равна 0,529. Решив эту систему, получаем окончательно:
Р1средн (по самотипированию) = 0,635;
Р2средн (по диагнозам MOLTI с использованием 220 диагностических вопросов) = 0,832.
Табл.19.
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | 13 | ||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Интеркорреляционная матрица различных показателей, связанных с надежностью социодиагностических опросников MOLTI. Расчет линейных корреляций на подвыборке 5790 респондентов MOLTI, заявивших также и свой тип по самооценке. (Средний уровень знакомства с соционикой в данной группе респондентов = 1,971) | Пол (1=м, 2=ж) | Возрастной диапазон | Уровень знакомства с соционикой (от 1 до 4) | Вероятность заявленного ТИМа по самооценке (в процентах) | S - сигма (стандотклон) типного профиля | А - надежность типного профиля по Кронбаху А=(S^2-0,0051)/ (S^2) | A^6 | Контраст формы профиля (близость к центру типного сектора): f=(h1-0,425*h2-0,353*h3)/h1 | Итоговый прогнозный показатель сходимости анкетного диагноза с заявленным типом: Z= A^6+2,2*f-0,45 | Лин. корреляция между типными профилями от двух половинок теста | Фишер корреляции между типными профилями от двух половинок теста | Сходимость двух типных диагнозов по половинкам теста (=1 или 0) | Сходимость анкетного диагноза с заявл. типом (=1 или 0) | |
| 1 | Пол (1=м, 2=ж) | 1,000 | -0,104 | -0,047 | -0,048 | 0,008 | 0,033 | 0,018 | 0,012 | 0,019 | 0,026 | 0,009 | 0,011 | 0,001 |
| 2 | Возрастной диапазон (1=до 20 лет, 2=21-25 лет, 3=26-30 лет, 4=31-40 лет, 5=41 лет и более) | -0,104 | 1,000 | 0,125 | 0,092 | 0,024 | 0,011 | 0,021 | 0,005 | 0,017 | 0,018 | 0,018 | -0,002 | 0,030 |
| 3 | Уровень знакомства с соционикой (от 1 до 4 по возрастанию) | -0,047 | 0,125 | 1,000 | 0,427 | 0,143 | 0,125 | 0,146 | 0,156 | 0,200 | 0,124 | 0,127 | 0,122 | 0,192 |
| 4 | Вероятность заявленного ТИМа по самооценке (в процентах) | -0,048 | 0,092 | 0,427 | 1,000 | 0,202 | 0,168 | 0,200 | 0,132 | 0,216 | 0,149 | 0,149 | 0,149 | 0,240 |
| 5 | S - сигма (стандотклон) типного профиля, представленного Фишерами от 16-ти диагностических корреляций | 0,008 | 0,024 | 0,143 | 0,202 | 1,000 | 0,801 | 0,961 | 0,162 | 0,704 | 0,656 | 0,709 | 0,338 | 0,314 |
| 6 | А - надежность типного профиля по Кронбаху А=(S^2-0,0051)/ (S^2) | 0,033 | 0,011 | 0,125 | 0,168 | 0,801 | 1,000 | 0,888 | 0,116 | 0,627 | 0,673 | 0,607 | 0,296 | 0,286 |
| 7 | A^6 | 0,018 | 0,021 | 0,146 | 0,200 | 0,961 | 0,888 | 1,000 | 0,145 | 0,716 | 0,704 | 0,706 | 0,342 | 0,322 |
| 8 | Контраст формы профиля (близость к центру типного сектора): f=(h1-0,425*h2-0,353*h3)/h1 (где h1 – самый высокий пик, h2 и h3 – второй и третий по высоте). | 0,012 | 0,005 | 0,156 | 0,132 | 0,162 | 0,116 | 0,145 | 1,000 | 0,795 | 0,119 | 0,135 | 0,571 | 0,373 |
| 9 | Итоговый прогнозный показатель сходимости анкетного диагноза с заявленным типом: Z= A^6+2,2*f-0,45 | 0,019 | 0,017 | 0,200 | 0,216 | 0,704 | 0,627 | 0,716 | 0,795 | 1,000 | 0,517 | 0,529 | 0,613 | 0,460 |
| 10 | Лин. корреляция типных профилей, независимо рассчитанных по двум половинкам теста при его расщеплении | 0,026 | 0,018 | 0,124 | 0,149 | 0,656 | 0,673 | 0,704 | 0,119 | 0,517 | 1,000 | 0,895 | 0,389 | 0,236 |
| 11 | Фишер корреляции между типными профилями от половинок теста | 0,009 | 0,018 | 0,127 | 0,149 | 0,709 | 0,607 | 0,706 | 0,135 | 0,529 | 0,895 | 1,000 | 0,401 | 0,229 |
| 12 | Сходимость двух типных диагнозов по половинкам теста (=1 или 0) | 0,011 | -0,002 | 0,122 | 0,149 | 0,338 | 0,296 | 0,342 | 0,571 | 0,613 | 0,389 | 0,401 | 1,000 | 0,309 |
| 13 | Сходимость анкетного диагноза с заявл. типом (=1 или 0) | 0,001 | 0,030 | 0,192 | 0,240 | 0,314 | 0,286 | 0,322 | 0,373 | 0,460 | 0,236 | 0,229 | 0,309 | 1,000 |
| Среднее значение показателя в подвыборке | 1,76 | 1,97 | 1,97 | 66,44 | 0,24 | 0,87 | 0,52 | 0,48 | 1,11 | 0,85 | 1,44 | 0,62 | 0,55 | |
| Медиана распределения показателя в подвыборке | 2,00 | 2,00 | 2,00 | 70,00 | 0,24 | 0,91 | 0,57 | 0,47 | 1,12 | 0,89 | 1,44 | 1,00 | 1,00 | |
| Стандартное отклонение показателя в подвыборке | 0,43 | 1,16 | 0,80 | 25,50 | 0,08 | 0,11 | 0,22 | 0,11 | 0,35 | 0,14 | 0,51 | 0,49 | 0,50 |
Табл.20.
| 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | ||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Интеркорреляционная матрица различных показателей, связанных с надежностью социодиагностических опросников MOLTI. Расчет линейных корреляций на подвыборке 4132 респондентов MOLTI, не указавших свой тип по самооценке. (Средний уровень знакомства с соционикой в данной группе респондентов = 1,192) | Пол (1=м, 2=ж) | Возрастной диапазон | Уровень знакомства с соционикой (от 1 до 4) | Вероятность заявленного ТИМа по самооценке (в процентах) | S - сигма (стандотклон) типного профиля | А - надежность типного профиля по Кронбаху А=(S^2-0,0051)/ (S^2) | A^6 | Контраст формы профиля (близость к центру типного сектора): f=(h1-0,425*h2-0,353*h3)/h1 | Итоговый прогнозный показатель сходимости анкетного диагноза с заявленным типом: Z= A^6+2,2*f-0,45 | Лин. корреляция типных профилей от двух половинок теста | Фишер корреляции между типными профилями от половинок теста | Сходимость двух типных диагнозов по половинкам теста (=1 или 0) | |
| 1 | Пол (1=м, 2=ж) | 1,000 | -0,026 | 0,027 | 0,113 | 0,113 | 0,129 | 0,019 | 0,100 | 0,104 | 0,092 | 0,037 | |
| 2 | Возрастной диапазон (1=до 20 лет, 2=21-25 лет, 3=26-30 лет, 4=31-40 лет, 5=41 лет и более) | -0,026 | 1,000 | 0,027 | 0,041 | 0,037 | 0,038 | -0,012 | 0,017 | 0,027 | 0,039 | -0,003 | |
| 3 | Уровень знакомства с соционикой (от 1 до 4 по возрастанию) | 0,027 | 0,027 | 1,000 | 0,082 | 0,056 | 0,082 | 0,060 | 0,097 | 0,067 | 0,071 | 0,043 | |
| 4 | Вероятность заявленного ТИМа по самооценке (в процентах) | ||||||||||||
| 5 | S - сигма (стандотклон) типного профиля, представленного Фишерами от 16-ти диагностических корреляций | 0,113 | 0,041 | 0,082 | 1,000 | 0,791 | 0,968 | 0,066 | 0,693 | 0,637 | 0,700 | 0,276 | |
| 6 | А - надежность типного профиля по Кронбаху А=(S^2-0,0051)/ (S^2) | 0,113 | 0,037 | 0,056 | 0,791 | 1,000 | 0,854 | 0,026 | 0,588 | 0,619 | 0,579 | 0,231 | |
| 7 | A^6 | 0,129 | 0,038 | 0,082 | 0,968 | 0,854 | 1,000 | 0,053 | 0,705 | 0,673 | 0,696 | 0,276 | |
| 8 | Контраст формы профиля (близость к центру типного сектора): f=(h1-0,425*h2-0,353*h3)/h1 (где h1 – самый высокий пик, h2 и h3 – второй и третий по высоте). | 0,019 | -0,012 | 0,060 | 0,066 | 0,026 | 0,053 | 1,000 | 0,745 | 0,032 | 0,040 | 0,530 | |
| 9 | Итоговый прогнозный показатель сходимости анкетного диагноза с заявленным типом: Z= A^6+2,2*f-0,45 | 0,100 | 0,017 | 0,097 | 0,693 | 0,588 | 0,705 | 0,745 | 1,000 | 0,472 | 0,493 | 0,560 | |
| 10 | Лин. корреляция типных профилей, независимо рассчитанных по двум половинкам теста при его расщеплении | 0,104 | 0,027 | 0,067 | 0,637 | 0,619 | 0,673 | 0,032 | 0,472 | 1,000 | 0,911 | 0,361 | |
| 11 | Фишер корреляции между типными профилями от половинок теста | 0,092 | 0,039 | 0,071 | 0,700 | 0,579 | 0,696 | 0,040 | 0,493 | 0,911 | 1,000 | 0,371 | |
| 12 | Сходимость двух типных диагнозов по половинкам теста (=1 или 0) | 0,037 | -0,003 | 0,043 | 0,276 | 0,231 | 0,276 | 0,530 | 0,560 | 0,361 | 0,371 | 1,000 | |
| Среднее значение показателя в подвыборке | 1,70 | 2,05 | 1,19 | 0,21 | 0,84 | 0,43 | 0,45 | 0,98 | 0,80 | 1,29 | 0,52 | ||
| Медиана распределения показателя в подвыборке | 2,00 | 2,00 | 1,00 | 0,20 | 0,88 | 0,45 | 0,45 | 0,98 | 0,85 | 1,26 | 1,00 | ||
| Стандартное отклонение показателя в подвыборке | 0,46 | 1,26 | 0,53 | 0,07 | 0,13 | 0,22 | 0,11 | 0,34 | 0,16 | 0,50 | 0,50 |
Из приведенных двух интеркорреляционных таблиц (составленных отдельно для респондентов, заявивших свой психотип, и его не заявивших) можно сделать следующие основные выводы:
- Все показатели сходимости (то есть сходимости анкетного диагноза с заявленным типом, либо сходимости между двумя типными диагнозами по половинкам анкеты) зависят не только от согласованности ответов респондента на вопросы анкеты (этот фактор отражен в индивидуальных показателях анкетной надежности №№ 5;6;7), но и от формы получающегося типного профиля, а именно от «чистоты» типа, близости его к центру соответствующего типного сектора (этот фактор отражен в показателе f, №8 в таблицах 19 и 20).
- Наилучшим прогнозным показателем для сходимости любых двух диагнозов наиболее близкого типа для конкретного респондента является интегральный показатель Z (№9 в таблице), учитывающий как психологическую компетентность респондента и, соответственно, согласованность и неслучайность его ответов в анкете, так и объективную близость респондента строго к центру одного из 16-ти стандартных психологических типов. Оба этих независимых фактора влияют также и на компетентность самотипирования в один из стандартных 16-ти психотипов.
- Устойчивое и сильное влияние на все показатели сходимости (в том числе и на сходимость диагнозов между анкетой и самотипированием) показателя f (близости респондента к центру психотипа, рассчитанной по форме измеренного типного профиля) однозначно указывает на объективный (неслучайный, неартефактный) характер непрерывного распределения респондентов на всем пространстве между психотипами, то есть на отсутствие «квантования» психотипов. В пользу этого факта свидетельствует также и высокая устойчивость показателя f (выражающего близость человека к центру одного из психотипов) – наблюдаемая как при расщеплении анкеты и независимом измерении этого показателя по двум даже весьма коротким и не идеально точно согласованным между собой в диагностическом плане половинкам анкеты (R=0,366 на 9922 испытуемых), так и при ретестах по целой анкете через 2-3 недели (для 376 испытуемых R=0,679 при построении первого и ретестового профилей по целой анкете, либо R=0,603 при построении первого и повторного ретестового профиля лишь по одной и той же половинке анкеты ). Тем самым можно считать полностью доказанными и некоторую условность выделения типных секторов в психологическом пространстве (всего лишь как маркерных точек, соответствующих местам наиболее ярких проявлений психологических свойств), и континуальный характер размещения представителей человеческой популяции во всем психологическом пространстве между психотипами. Люди по своим личностно устойчивым психологическим координатам размещаются не только в центре типных секторов, но и непрерывным образом заполняют все многочисленные пограничные зоны между условно выделяемыми типами (маркерными точками психологического пространства), о чем и свидетельствуют как объективно устойчивый характер показателя f, так и его сильное влияние на сходимость типных диагнозов (то есть на сходимость двух независимых процедур по определению наиболее по свойствам близкого человеку психотипа).
- Показатели индивидуальной надежности измеряемого анкетой типного профиля вполне достаточны у большинства испытуемых. Напомним, что первым таким индивидуальным показателем надежности результатов является корреляция между двумя профилями, рассчитанными независимо по двум половинкам теста у одного и того же испытуемого (индивидуальная надежность у конкретного респондента по методу тождественных частей). Второй показатель индивидуальной надежности результатов теста «в целом» – это надежность полученного типного профиля, рассчитанная по Кронбаху (величина А, см. № 6 в таблице). Средние значения и медианы обоих этих показателей в выборках достаточно велики. Так, медиана линейной корреляции между типными профилями, независимо рассчитанными по двум половинкам тест-анкеты (надежность «методом расщепления теста») равна для выборки людей, указавших свой тип, 0,893, и для выборки людей, свой тип не указавших, медиана равна 0,852. Для метода расщепления это – вполне высокие показатели надежности теста. Индивидуальный для каждого респондента показатель надежности теста, измеренный методом расщепления как корреляция двух типных профилей, независимо измеренных по половинкам теста, оказывается высоко скоррелированным и с другим индивидуальным показателем надежности типного профиля, рассчитанным по методу Кронбаха (см. в таблице корреляции показателя А и производных от него величин – S и A^6).
- Медиана надежности типного профиля, измеренной по методу Кронбаха (показатель А) равна для первой выборки (люди, заявившие свой тип) 0,91, и для второй выборки (люди, не заявившие свой тип) 0,88. В целом же по всем 9922 испытуемым медиана этого индивидуального показателя надежности типного профиля равна 0,90. Это вполне достаточная для профессиональных психологических тестов величина, указывающая на высокую надежность в определении формы полного типного профиля, состоящего из набора 16 чисел (для анкет NZ и SZ, состоящих не из 218-230, как в случае анкет MOLTI, а из 584 диагностических вопросов, этот показатель надежности получается еще выше, в своей медиане достигая 0,95).
Проверка этой ретестовой надежности была произведена по тем 376 респондентам, которые одну и ту же версию анкеты MOLTI независимо заполнили дважды с примерным интервалом между заполнениями в 2-3 недели. В пределах одной и той же анкетной формы ретесты выявляются легко по целостному вектору 330 сырых ответов респондента (два вектора сырых ответов являются тестом и ретестом одного и того же респондента, если корреляция между ними значительно превышает третью по величине корреляцию этих же векторов ответов со всеми иными векторами сырых ответов на всем массиве выборки).
Результаты, иллюстрирующие ретестовые испытания, приведены в двух таблицах ниже.
Показатель сходимости двух типных диагнозов тест-ретест равен 0,697. Это больше, чем показанный выше аналогичный показатель сходимости при определении типа независимо по двум половинкам теста (средняя величина которого была 0,579 на 9922 испытуемых). Обратим внимание на то, что этот показатель тест-ретест сходимости остается все равно меньше чем 0,7, хотя корреляция тест-ретест между самими типными профилями в своей медиане равна 0,965, то есть гораздо больше величины 0,7. Это связано с тем, что психотипы не квантуются, что и отражено в широком разбросе среди испытуемых показателя f=(h1-0,425*h2-0,353*h3)/h1 (где h1, h2, h3 – высота трех наивысших пиков в типном профиле в порядке их убывания). Испытуемых можно считать принадлежащими к «чистым типам» (то есть не «пограничными»), только если показатель f их типного профиля достаточно высок. Если разбить всех испытуемых на две группы – с более высоким и с более низким значением показателя f – то показатели сходимости в этих двух подгруппах радикально различаются.
В первой подгруппе (с высокой f) сходимость диагнозов по двум независимым половинкам теста при его расщеплении равна 0,831 (в среднем по 4961 респондентам, их fсредн.=0,559), а сходимость в процедуре тест-ретест оказывается равна 0,91 (в среднем по 188 респондентам). Во второй подгруппе, с низкой при усреднении по тесту и ретесту величиной f (то есть для испытуемых с пограничным типом) сходимость диагнозов по двум независимым половинкам теста (при его расщеплении) равна лишь 0,327 (в среднем по 4961 респондентам, их fсредн.=0,374), а сходимость в процедуре тест-ретест оказывается тоже гораздо меньше и равна 0,48 (в среднем по 188 респондентам).
Еще раз поясним, почему у испытуемых с низкой величиной f (то есть пограничных в своем психотипе) значительно снижается сходимость двух типных диагнозов как в процедурах тест-ретест, так и между двумя половинками одного теста, хотя показатели надежности типного профиля (и высота этого профиля S) у этих испытуемых в целом ничуть не хуже, чем у респондентов с высокими значениями f. Дело в том, что у респондентов с низкой f сразу два, а то и три пика типного профиля очень близки друг к другу по своей высоте (потому тип этих испытуемых мы и называем пограничным). А если два пика близки по своей высоте, то даже небольшие вариации этой высоты при повторном тестировании (или при тестировании по другой половинке теста) легко могут вызвать перемену первого и второго по высоте пиков местами, то есть привести к смене типного диагноза. Понятно, что у испытуемых «не пограничных», имеющих большую величину f профиля и только один высокий в нем пик, такого не происходит, а потому и сходимость диагнозов в этой группе испытуемых с «чистыми» типами значительно увеличивается и приближается непосредственно к величине квадрата корреляции между двумя типными профилями.
Принадлежность испытуемого к условно «чистому» или условно «пограничному» типу является величиной личностно достаточно устойчивой, что и отражено в значительной величине корреляции тест-ретест для характеризующего «чистоту» типа респондента показателя f (его тест-ретест корреляция R=0,68). С другой стороны, величина этой тест-ретест корреляции все же меньше, чем для других показателей, характеризующих типный профиль респондента. Из этого можно сделать вывод, что типный профиль респондента может в определенных пределах «гулять» по относительной силе своих пиков – в частности, возможно, в зависимости от психического состояния респондента. Видимо, вариабельность профиля при ретестах определяется не только случайными ошибками (то есть будучи связана с низким интеллектом, низкой старательностью либо низкими значениями фактора психологической компетентности), но связана и с «экспериментаторской установкой» человека, а отчасти может быть и объективно разной для людей с разными психическими свойствами, отражая у них объективные сдвиги самооценок в зависимости от психического состояния. Этот вопрос нуждается в дополнительном изучении - выборки в 376 человек для окончательных выводов тут недостаточно, так как для показателя интегральной вариабельности профиля (за который удобно принимать квазинормально распределенную величину «Логарифм от суммы квадратов разностей», где разность измеряется между одноименными пиками тестового и ретестового профилей) его корреляции с любыми соционическими показателями испытуемых весьма малы и по абсолютной величине не превышают 0,10 (а для выборки в 376 человек это находится на уровне шума).
Табл.21.
| N (число респондентов с парой анкет тест-ретест) | минимальное на выборке значение корреляции между векторами сырых 330 ответов теста и ретеста | Максимальное на выборке значение корреляции между векторами сырых 330 ответов теста и ретеста | минимальное на выборке значение корреляции между типными профилями теста и ретеста | максимальное на выборке значение корреляции между типными профилями теста и ретеста | среднее значение корреляций между типными профилями теста и ретеста | медиана в распределении корреляций между типными профилями теста и ретеста | Средняя на выборке сходимость между самым высоким пиком типного профиля в тесте и ретесте (то есть сходимость ТИМов, диагностированных по тесту и ретесту) |
|---|---|---|---|---|---|---|---|
| 376 | 0,54 | 0,92 | -0,173 | 0,999 | 0,919 | 0,965 | 0,697 |
Табл.22.
| Пики типного профиля, между высотой которых измеряются корреляции тест-ретест, и производные из типного профиля соционические величины | Лин.корреляции тест-ретест для высоты пиков непосредственно полученного типного профиля и пересчитанных из этих типных профилей признаков и функций | Лин.корреляции тест-ретест после нормировки измеренных типных профилей к одинаковому единичному стандартному отклонению |
|---|---|---|
| ИЛЭ | 0,930 | 0,917 |
| ЛИИ | 0,944 | 0,926 |
| СЭИ | 0,925 | 0,913 |
| ЭСЭ | 0,932 | 0,907 |
| СЛЭ | 0,935 | 0,917 |
| ЛСИ | 0,950 | 0,933 |
| ИЭИ | 0,936 | 0,896 |
| ЭИЭ | 0,948 | 0,931 |
| СЭЭ | 0,942 | 0,920 |
| ЭСИ | 0,932 | 0,907 |
| ИЛИ | 0,932 | 0,905 |
| ЛИЭ | 0,912 | 0,876 |
| ИЭЭ | 0,950 | 0,934 |
| ЭИИ | 0,931 | 0,909 |
| СЛИ | 0,952 | 0,936 |
| ЛСЭ | 0,931 | 0,891 |
| ЭКСТРАВЕРТ | 0,948 | 0,931 |
| ИРРАЦИОНАЛ | 0,922 | 0,892 |
| СТАТИК | 0,912 | 0,885 |
| ИНТУИТ | 0,940 | 0,919 |
| РАССУДИТЕЛЬНЫЙ | 0,934 | 0,916 |
| ТАКТИК | 0,859 | 0,819 |
| БЕСПЕЧНЫЙ | 0,850 | 0,816 |
| ЛОГИК | 0,934 | 0,910 |
| ВЕСЕЛЫЙ | 0,927 | 0,886 |
| КОНСТРУКТИВИСТ | 0,924 | 0,886 |
| УСТУПЧИВЫЙ | 0,889 | 0,856 |
| КВЕСТИМ | 0,898 | 0,885 |
| ДЕМОКРАТ | 0,909 | 0,870 |
| ПОЗИТИВИСТ | 0,923 | 0,885 |
| ПРОЦЕССОР | 0,921 | 0,883 |
| БИ | 0,929 | 0,901 |
| ЧИ | 0,947 | 0,928 |
| БС | 0,936 | 0,926 |
| ЧС | 0,940 | 0,916 |
| БЛ | 0,940 | 0,922 |
| ЧЛ | 0,929 | 0,894 |
| БЭ | 0,918 | 0,898 |
| ЧЭ | 0,946 | 0,922 |
| БК | 0,945 | 0,929 |
| ЧК | 0,935 | 0,909 |
| БД | 0,939 | 0,922 |
| ЧД | 0,928 | 0,885 |
| S (сигма, станд.отклонение типного профиля) | 0,875 | |
| A= (S^2-0,0051)/ (S^2) | 0,719 | |
| f=(h1-0,425*h2-0,353*h3)/h1 | 0,679 |
В статье показано, как применять метод Кронбаха для оценки надежности опросниковых шкал, основанных на измерении корреляцмй или ковариаций ответов респондентов с диагностическими векторами.
Разработаны специальные параметры f и Z для прогноза сходимости двух независимых дискретных диагнозов на выборке респондентов, которые в реальности распределены континуально между реперными точками диагнозов. С использованием параметра f (раздел 8 статьи) показано, что психологическое пространство между дискретными психотипами действительно является континуально заполненным респондентами выборки. Одновременная близость респондента к двум, а то и к трем типам является нередким случаем и является причиной обязательного и рассчитываемого снижения сходимости независимых диагнозов даже при условии высокой надежности типного профиля респондентов и значительной высоты этого профиля.
Конкретно в отношении социодиагностических опросников Таланова (в том числе опросников серии MOLTI) показано, что измеряемые ими соционические показатели удовлетворяют всем требованиям критериев надежности (альфы Кронбаха, корреляций тождественных частей и ретестовых корреляций), которые предъявляются к профессиональным психодиагностическим опросникам.
С точки зрения требований к надежности тестирования разработаны количественные критерии для анкетных вопросов, позволяющие производить математически осмысленный отбор вопросов в диагностические шкалы любых психологических опросников.
Для случая диагностики соционических типов в разделах 10-14 подробно проанализированы все факторы, приводящие к неодинаковому уровню накопления ошибок (а в итоге – и к разной сходимости) в различных типных группах испытуемых. При этом отдельно рассмотрены случаи формирования этих типных групп как по результатам самотипирования, так и по результатам анкетного типирования.
В разделе 15 статьи показан способ раздельного расчета вероятностей правильного определения истинного типа при самотипировании и при анкетной диагностике, исходя из сходимости соответствующих диагнозов и из дисперсии средних сходимостей в 16-ти группах психотипов (рассчитанной отдельно для типных групп по самотипированию и по анкетной диагностике). Для самотипирования расчет показывает средневыборочнвую вероятность правильного определения истинного типа около 63%, а для диагностики по анкетам MOLTI c 220 диагностическими вопросами – в среднем по выборке около 83%.
В.Л.Таланов Исследование взаимосвязи между логическими и этико-эмоциональными способностями (2017 г.): http://sociotoday.narod.ru/corFT.docx
В.Л.Таланов Исследование взаимосвязи между интуитивными и сенсорными способностями (2017 г.): http://sociotoday.narod.ru/corNS.docx
В.Л.Таланов Валидность психодиагностических опросников В.Л.Таланова в свете эмпирически выявленного семантического наполнения соционических функций психики (2017 г.): http://sociotoday.narod.ru/val_funk.docx
В.Л.Таланов. Всё неизвестное и малоизвестное о восьми функциях психики. Часть I: Расчёт функций, количественное значение всех функций в психотипе, содержательное наполнение функций: http://sociotoday.narod.ru/funkcii1.html
В.Л.Таланов. Всё неизвестное и малоизвестное о восьми функциях психики. Часть II: К семантике функций в программном и творческом положении: http://sociotoday.narod.ru/funkcii2.html
В.Л.Таланов. Подробное исследование кластеров черной сенсорики (2016 г.): http://sociotoday.narod.ru/funkc_bs.html
В.Л.Таланов. Подробное исследование кластеров белой сенсорики (2016 г.): http://sociotoday.narod.ru/funkc_ws.html
В.Л.Таланов. Квантуются ли психологические типы? Проверка плотности популяционного распределения на границах между 16-ю «стандартными» психотипами. Введение новых 4-х функций психики. (2016 г.): http://sociotoday.narod.ru/funkc_3.html
В.Л.Таланов. Экспериментальное исследование валидности социодиагностических методик (и сходимости соционических диагнозов в том числе) – декабрь 2013г.: http://sociotoday.narod.ru/validnost.htm
Условия воспроизведения статьи:
Автор-правообладатель разрешает свободное воспроизведение в интернете статьи при условии гиперссылки на первоисточник: http://sociotoday.narod.ru/nadejn1.docx
Контакты:
Вопросы и предложения в связи с настоящей публикацией можно направлять для автора - Виктора Львовича Таланова - на почтовый ящик boxforfunkciibs3@yandex.ru (используется только для получения научной корреспонденции в связи с публикациями).
© Таланов В.Л. 2017
см. также:
В.Л.Таланов. Перечень 1000 соционических персоналий (исторических фигур и известных современников) с примерами подробного разбора и обоснования психотипов: http://sociotoday.narod.ru/tabl.html
Переход к оглавлению сайта с работами В.Л.Таланова и перечню всех статей сайта: http://sociotoday.narod.ru/index1.html
Предыдущие работы В.Л.Таланова (до 2011 года) можно найти также на сайте: http://www.newsocionicsmodel.narod.ru
На соционическом форуме http://www.socioforum.su/search.php?st=7&sk=t&sd=d&sr=topics&search_id=active_topics нередко происходит обсуждение статей автора, вы можете принять в нем участие.